数据库面试题
基本原理
1.什么是存储过程?有哪些优缺点?
什么是存储过程?有哪些优缺点?
存储过程就像我们编程语言中的函数一样,封装了我们的代码(PLSQL、T-SQL)。
存储过程的优点:
- 能够将代码封装起来
- 保存在数据库之中
- 让编程语言进行调用
- 存储过程是一个预编译的代码块,执行效率比较高
- 一个存储过程替代大量T_SQL语句 ,可以降低网络通信量,提高通信速率
存储过程的缺点:
- 每个数据库的存储过程语法几乎都不一样,十分难以维护(不通用)
- 业务逻辑放在数据库上,难以迭代
2.三个范式是什么
三个范式是什么
第一范式(1NF):数据库表中的字段都是单一属性的,不可再分。这个单一属性由基本类型构成,包括整型、实数、字符型、逻辑型、日期型等。 第二范式(2NF):数据库表中不存在非关键字段对任一候选关键字段的部分函数依赖(部分函数依赖指的是存在组合关键字中的某些字段决定非关键字段的情况),也即所有非关键字段都完全依赖于任意一组候选关键字。 第三范式(3NF):在第二范式的基础上,数据表中如果不存在非关键字段对任一候选关键字段的传递函数依赖则符合第三范式。所谓传递函数依赖,指的是如果存在"A → B → C"的决定关系,则C传递函数依赖于A。因此,满足第三范式的数据库表应该不存在如下依赖关系: 关键字段 → 非关键字段x → 非关键字段y
上面的文字我们肯定是看不懂的,也不愿意看下去的。接下来我就总结一下:
首先要明确的是:满足着第三范式,那么就一定满足第二范式、满足着第二范式就一定满足第一范式
第一范式:
字段是最小的的单元不可再分
- 学生信息组成学生信息表,有年龄、性别、学号等信息组成。这些字段都不可再分,所以它是满足第一范式的
第二范式:满足第一范式,
表中的字段必须完全依赖于全部主键而非部分主键。
- 其他字段组成的这行记录和主键表示的是同一个东西,而主键是唯一的,它们只需要依赖于主键,也就成了唯一的
- 学号为1024的同学,姓名为Java3y,年龄是22岁。姓名和年龄字段都依赖着学号主键。
第三范式:满足第二范式,
非主键外的所有字段必须互不依赖
- 就是数据只在一个地方存储,不重复出现在多张表中,可以认为就是消除传递依赖
- 比如,我们大学分了很多系(中文系、英语系、计算机系……),这个系别管理表信息有以下字段组成:系编号,系主任,系简介,系架构。那我们能不能在学生信息表添加系编号,系主任,系简介,系架构字段呢?不行的,因为这样就冗余了,非主键外的字段形成了依赖关系(依赖到学生信息表了)!正确的做法是:学生表就只能增加一个系编号字段。
3.什么是视图?以及视图的使用场景有哪些?
什么是视图?以及视图的使用场景有哪些?
视图是一种基于数据表的一种虚表
- (1)视图是一种虚表
- (2)视图建立在已有表的基础上, 视图赖以建立的这些表称为基表
- (3)向视图提供数据内容的语句为 SELECT 语句,可以将视图理解为存储起来的 SELECT 语句
- (4)视图向用户提供基表数据的另一种表现形式
- (5)视图没有存储真正的数据,真正的数据还是存储在基表中
- (6)程序员虽然操作的是视图,但最终视图还会转成操作基表
- (7)一个基表可以有0个或多个视图
有的时候,我们可能只关系一张数据表中的某些字段,而另外的一些人只关系同一张数据表的某些字段...
那么把全部的字段都都显示给他们看,这是不合理的。
我们应该做到:他们想看到什么样的数据,我们就给他们什么样的数据...一方面就能够让他们只关注自己的数据,另一方面,我们也保证数据表一些保密的数据不会泄露出来...
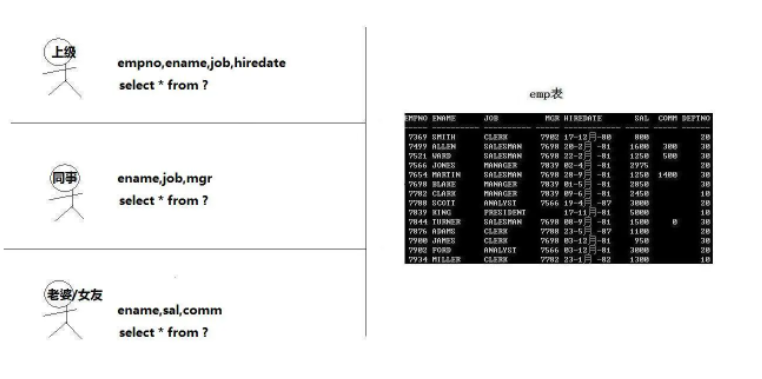
我们在查询数据的时候,常常需要编写非常长的SQL语句,几乎每次都要写很长很长....上面已经说了,视图就是基于查询的一种虚表,也就是说,视图可以将查询出来的数据进行封装。。。那么我们在使用的时候就会变得非常方便...
值得注意的是:使用视图可以让我们专注与逻辑,但不提高查询效率
4.drop、delete与truncate分别在什么场景之下使用?
drop、delete与truncate分别在什么场景之下使用?
我们来对比一下他们的区别:
drop table
- 1)属于DDL
- 2)不可回滚
- 3)不可带where
- 4)表内容和结构删除
- 5)删除速度快
truncate table
- 1)属于DDL
- 2)不可回滚
- 3)不可带where
- 4)表内容删除
- 5)删除速度快
delete from
- 1)属于DML
- 2)可回滚
- 3)可带where
- 4)表结构在,表内容要看where执行的情况
- 5)删除速度慢,需要逐行删除
- 不再需要一张表的时候,用drop
- 想删除部分数据行时候,用delete,并且带上where子句
- 保留表而删除所有数据的时候用truncate
5.什么是事务?
什么是事务?
事务简单来说:一个Session中所进行所有的操作,要么同时成功,要么同时失败
ACID — 数据库事务正确执行的四个基本要素
- 包含:原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)、持久性(Durability)。
一个支持事务(Transaction)中的数据库系统,必需要具有这四种特性,否则在事务过程(Transaction processing)当中无法保证数据的正确性,交易过程极可能达不到交易。
举个例子:A向B转账,转账这个流程中如果出现问题,事务可以让数据恢复成原来一样【A账户的钱没变,B账户的钱也没变】。
6.超键、候选键、主键、外键分别是什么?
超键、候选键、主键、外键分别是什么?
- 超键:在关系中能唯一标识元组的属性集称为关系模式的超键。一个属性可以为作为一个超键,多个属性组合在一起也可以作为一个超键。超键包含候选键和主键。
- 候选键(候选码):是最小超键,即没有冗余元素的超键。
- 主键(主码):数据库表中对储存数据对象予以唯一和完整标识的数据列或属性的组合。一个数据列只能有一个主键,且主键的取值不能缺失,即不能为空值(Null)。
- 外键:在一个表中存在的另一个表的主键称此表的外键。
候选码和主码:
例子:邮寄地址(城市名,街道名,邮政编码,单位名,收件人)
- 它有两个候选键:{城市名,街道名} 和 {街道名,邮政编码}
- 如果我选取{城市名,街道名}作为唯一标识实体的属性,那么{城市名,街道名} 就是主码(主键)
7.数据库的乐观锁和悲观锁是什么?
数据库的乐观锁和悲观锁是什么?
确保在多个事务同时存取数据库中同一数据时不破坏事务的隔离性和统一性以及数据库的统一性,乐观锁和悲观锁是并发控制主要采用的技术手段。
- 悲观锁:假定会发生并发冲突,屏蔽一切可能违反数据完整性的操作
- 在查询完数据的时候就把事务锁起来,直到提交事务
- 实现方式:使用数据库中的锁机制
- 乐观锁:假设不会发生并发冲突,只在提交操作时检查是否违反数据完整性。
- 在修改数据的时候把事务锁起来,通过version的方式来进行锁定
- 实现方式:使用version版本或者时间戳
悲观锁:
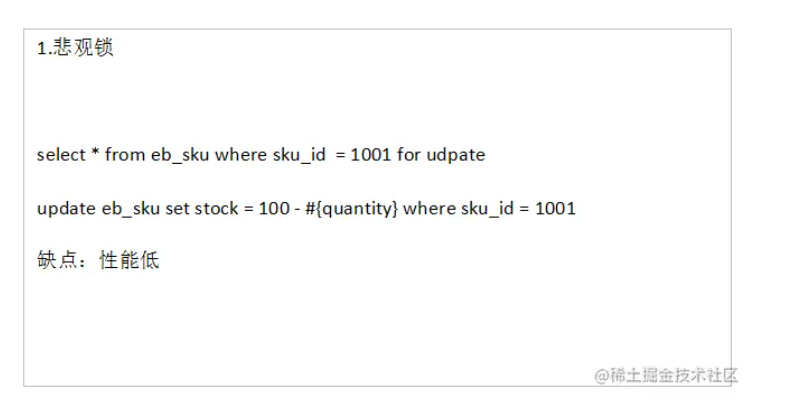
乐观锁:
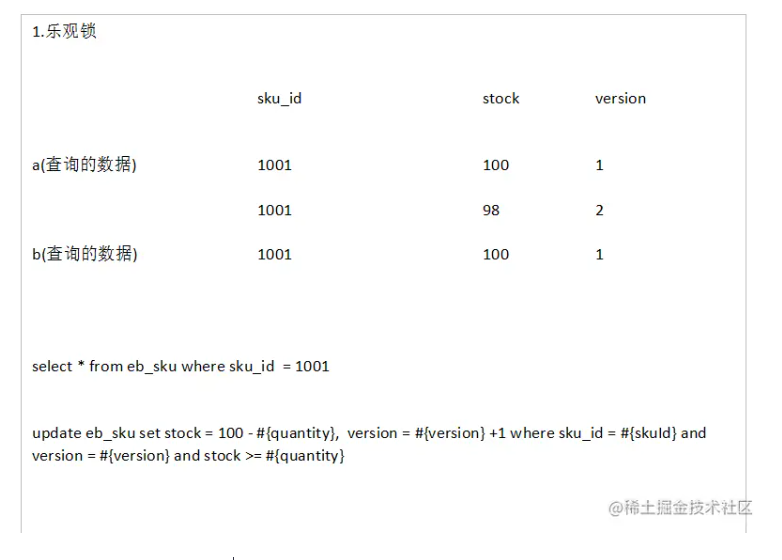
8.超键、候选键、主键、外键分别是什么?
超键、候选键、主键、外键分别是什么?
- 超键:在关系中能唯一标识元组的属性集称为关系模式的超键。一个属性可以为作为一个超键,多个属性组合在一起也可以作为一个超键。超键包含候选键和主键。
- 候选键(候选码):是最小超键,即没有冗余元素的超键。
- 主键(主码):数据库表中对储存数据对象予以唯一和完整标识的数据列或属性的组合。一个数据列只能有一个主键,且主键的取值不能缺失,即不能为空值(Null)。
- 外键:在一个表中存在的另一个表的主键称此表的外键。
候选码和主码:
例子:邮寄地址(城市名,街道名,邮政编码,单位名,收件人)
- 它有两个候选键:{城市名,街道名} 和 {街道名,邮政编码}
- 如果我选取{城市名,街道名}作为唯一标识实体的属性,那么{城市名,街道名} 就是主码(主键)
9.SQL 约束有哪几种?
NOT NULL: 用于控制字段的内容一定不能为空(NULL)。
UNIQUE: 控件字段内容不能重复,一个表允许有多个 Unique 约束。
PRIMARY KEY: 也是用于控件字段内容不能重复,但它在一个表只允许出现一个。
FOREIGN KEY: 用于预防破坏表之间连接的动作,也能防止非法数据插入外键列,因为它必须是它指向的那个表中的值之一。
CHECK: 用于控制字段的值范围。
10.关系型和非关系型数据库区别
非关系型数据库(感觉翻译不是很准确)称为 NoSQL,也就是 Not Only SQL,不仅仅是 SQL。非关系型数据库不需要写一些复杂的 SQL 语句,其内部存储方式是以 key-value 的形式存在可以把它想象成电话本的形式,每个人名(key)对应电话(value)。常见的非关系型数据库主要有 Hbase、Redis、MongoDB 等。非关系型数据库不需要经过 SQL 的重重解析,所以性能很高;非关系型数据库的可扩展性比较强,数据之间没有耦合性,遇见需要新加字段的需求,就直接增加一个 key-value 键值对即可。
关系型数据库以表格的形式存在,以行和列的形式存取数据,关系型数据库这一系列的行和列被称为表,无数张表组成了数据库,常见的关系型数据库有 Oracle、DB2、Microsoft SQL Server、MySQL等。关系型数据库能够支持复杂的 SQL 查询,能够体现出数据之间、表之间的关联关系;关系型数据库也支持事务,便于提交或者回滚
11.数据库优化的思路
SQL优化
在我们书写SQL语句的时候,其实书写的顺序、策略会影响到SQL的性能,虽然实现的功能是一样的,但是它们的性能会有些许差别。
因此,下面就讲解在书写SQL的时候,怎么写比较好。
①选择最有效率的表名顺序
数据库的解析器按照从右到左的顺序处理FROM子句中的表名,FROM子句中写在最后的表将被最先处理
在FROM子句中包含多个表的情况下:
- 如果三个表是完全无关系的话,将记录和列名最少的表,写在最后,然后依次类推
- 也就是说:选择记录条数最少的表放在最后
如果有3个以上的表连接查询:
- 如果三个表是有关系的话,将引用最多的表,放在最后,然后依次类推。
- 也就是说:被其他表所引用的表放在最后
例如:查询员工的编号,姓名,工资,工资等级,部门名
emp表被引用得最多,记录数也是最多,因此放在form字句的最后面
select emp.empno,emp.ename,emp.sal,salgrade.grade,dept.dname
from salgrade,dept,emp
where (emp.deptno = dept.deptno) and (emp.sal between salgrade.losal and salgrade.hisal)
②WHERE子句中的连接顺序
数据库采用自右而左的顺序解析WHERE子句,根据这个原理,表之间的连接必须写在其他WHERE条件之左,那些可以过滤掉最大数量记录的条件必须写在WHERE子句的之右。
emp.sal可以过滤多条记录,写在WHERE字句的最右边
      select emp.empno,emp.ename,emp.sal,dept.dname
      from dept,emp
      where (emp.deptno = dept.deptno) and (emp.sal > 1500)
③SELECT子句中避免使用*号
我们当时学习的时候,“*”号是可以获取表中全部的字段数据的。
- 但是它要通过查询数据字典完成的,这意味着将耗费更多的时间
- 使用*号写出来的SQL语句也不够直观。
④用TRUNCATE替代DELETE
这里仅仅是:删除表的全部记录,除了表结构才这样做。
DELETE是一条一条记录的删除,而Truncate是将整个表删除,保留表结构,这样比DELETE快
⑤多使用内部函数提高SQL效率
例如使用mysql的concat()函数会比使用||来进行拼接快,因为concat()函数已经被mysql优化过了。
⑥使用表或列的别名
如果表或列的名称太长了,使用一些简短的别名也能稍微提高一些SQL的性能。毕竟要扫描的字符长度就变少了。。。
⑦多使用commit
comiit会释放回滚点...
⑧善用索引
索引就是为了提高我们的查询数据的,当表的记录量非常大的时候,我们就可以使用索引了。
⑨SQL写大写
我们在编写SQL 的时候,官方推荐的是使用大写来写关键字,因为Oracle服务器总是先将小写字母转成大写后,才执行
⑩避免在索引列上使用NOT
因为Oracle服务器遇到NOT后,他就会停止目前的工作,转而执行全表扫描
①①避免在索引列上使用计算
WHERE子句中,如果索引列是函数的一部分,优化器将不使用索引而使用全表扫描,这样会变得变慢
①②用 >= 替代 >
      低效:
      SELECT * FROM EMP WHERE DEPTNO > 3
      首先定位到DEPTNO=3的记录并且扫描到第一个DEPT大于3的记录
      高效:
      SELECT * FROM EMP WHERE DEPTNO >= 4
      直接跳到第一个DEPT等于4的记录
①③用IN替代OR
      select * from emp where sal = 1500 or sal = 3000 or sal = 800;
      select * from emp where sal in (1500,3000,800);
①④总是使用索引的第一个列
如果索引是建立在多个列上,只有在它的第一个列被WHERE子句引用时,优化器才会选择使用该索引。 当只引用索引的第二个列时,不引用索引的第一个列时,优化器使用了全表扫描而忽略了索引
      create index emp_sal_job_idex
      on emp(sal,job);
      ----------------------------------
      select *
      from emp
      where job != 'SALES';


      上边就不使用索引了。
数据库结构优化
- 1)范式优化: 比如消除冗余(节省空间。。)
- 2)反范式优化:比如适当加冗余等(减少join)
- 3)拆分表: 垂直拆分和水平拆分
服务器硬件优化
MySql
MySQL 事务四大特性
一说到 MySQL 事务,你肯定能想起来四大特性:原子性、一致性、隔离性、持久性,下面再对这事务的四大特性做一个描述
原子性(Atomicity): 原子性指的就是 MySQL 中的包含事务的操作要么全部成功、要么全部失败回滚,因此事务的操作如果成功就必须要全部应用到数据库,如果操作失败则不能对数据库有任何影响。
这里涉及到一个概念,什么是 MySQL 中的事务?
事务是一组操作,组成这组操作的各个单元,要不全都成功要不全都失败,这个特性就是事务。
在 MySQL 中,事务是在引擎层实现的,只有使用
innodb引擎的数据库或表才支持事务。
一致性(Consistency):一致性指的是一个事务在执行前后其状态一致。比如 A 和 B 加起来的钱一共是 1000 元,那么不管 A 和 B 之间如何转账,转多少次,事务结束后两个用户的钱加起来还得是 1000,这就是事务的一致性。持久性(Durability): 持久性指的是一旦事务提交,那么发生的改变就是永久性的,即使数据库遇到特殊情况比如故障的时候也不会产生干扰。隔离性(Isolation):隔离性需要重点说一下,当多个事务同时进行时,就有可能出现脏读(dirty read)、不可重复读(non-repeatable read)、幻读(phantom read)的情况,为了解决这些并发问题,提出了隔离性的概念。
脏读:事务 A 读取了事务 B 更新后的数据,但是事务 B 没有提交,然后事务 B 执行回滚操作,那么事务 A 读到的数据就是脏数据
不可重复读:事务 A 进行多次读取操作,事务 B 在事务 A 多次读取的过程中执行更新操作并提交,提交后事务 A 读到的数据不一致。
幻读:事务 A 将数据库中所有学生的成绩由 A -> B,此时事务 B 手动插入了一条成绩为 A 的记录,在事务 A 更改完毕后,发现还有一条记录没有修改,那么这种情况就叫做出现了幻读。
SQL的隔离级别有四种,它们分别是读未提交(read uncommitted)、读已提交(read committed)、可重复读(repetable read) 和 串行化(serializable)。下面分别来解释一下。
读未提交:读未提交指的是一个事务在提交之前,它所做的修改就能够被其他事务所看到。
读已提交:读已提交指的是一个事务在提交之后,它所做的变更才能够让其他事务看到。
可重复读:可重复读指的是一个事务在执行的过程中,看到的数据是和启动时看到的数据是一致的。未提交的变更对其他事务不可见。
串行化:顾名思义是对于同一行记录,写会加写锁,读会加读锁。当出现读写锁冲突的时候,后访问的事务必须等前一个事务执行完成,才能继续执行。
这四个隔离级别可以解决脏读、不可重复读、幻象读这三类问题。总结如下
| 事务隔离级别 | 脏读 | 不可重复读 | 幻读 |
|---|---|---|---|
| 读未提交 | 允许 | 允许 | 允许 |
| 读已提交 | 不允许 | 允许 | 允许 |
| 可重复读 | 不允许 | 不允许 | 允许 |
| 串行化 | 不允许 | 不允许 | 不允许 |
其中隔离级别由低到高是:读未提交 < 读已提交 < 可重复读 < 串行化
隔离级别越高,越能够保证数据的完整性和一致性,但是对并发的性能影响越大。大多数数据库的默认级别是读已提交(Read committed),比如 Sql Server、Oracle ,但是 MySQL 的默认隔离级别是 可重复读(repeatable-read)。
MySQL 常见存储引擎的区别
MySQL 常见的存储引擎,可以使用
SHOW ENGINES
命令,来列出所有的存储引擎
InnoDB 是 MySQL 默认支持的存储引擎,支持事务、行级锁定和外键
MyISAM 存储引擎的特点
在 5.1 版本之前,MyISAM 是 MySQL 的默认存储引擎,MyISAM 并发性比较差,使用的场景比较少,主要特点是
不支持
事务操作,ACID 的特性也就不存在了,这一设计是为了性能和效率考虑的。不支持
外键操作,如果强行增加外键,MySQL 不会报错,只不过外键不起作用。MyISAM 默认的锁粒度是
表级锁,所以并发性能比较差,加锁比较快,锁冲突比较少,不太容易发生死锁的情况。MyISAM 会在磁盘上存储三个文件,文件名和表名相同,扩展名分别是
.frm(存储表定义)、.MYD(MYData,存储数据)、MYI(MyIndex,存储索引)。这里需要特别注意的是 MyISAM 只缓存索引文件,并不缓存数据文件。MyISAM 支持的索引类型有
全局索引(Full-Text)、B-Tree 索引、R-Tree 索引Full-Text 索引:它的出现是为了解决针对文本的模糊查询效率较低的问题。
B-Tree 索引:所有的索引节点都按照平衡树的数据结构来存储,所有的索引数据节点都在叶节点
R-Tree索引:它的存储方式和 B-Tree 索引有一些区别,主要设计用于存储空间和多维数据的字段做索引,目前的 MySQL 版本仅支持 geometry 类型的字段作索引,相对于 BTREE,RTREE 的优势在于范围查找。
数据库所在主机如果宕机,MyISAM 的数据文件容易损坏,而且难以恢复。
增删改查性能方面:SELECT 性能较高,适用于查询较多的情况
InnoDB 存储引擎的特点
自从 MySQL 5.1 之后,默认的存储引擎变成了 InnoDB 存储引擎,相对于 MyISAM,InnoDB 存储引擎有了较大的改变,它的主要特点是
- 支持事务操作,具有事务 ACID 隔离特性,默认的隔离级别是
可重复读(repetable-read)、通过MVCC(并发版本控制)来实现的。能够解决脏读和不可重复读的问题。 - InnoDB 支持外键操作。
- InnoDB 默认的锁粒度
行级锁,并发性能比较好,会发生死锁的情况。 - 和 MyISAM 一样的是,InnoDB 存储引擎也有
.frm文件存储表结构定义,但是不同的是,InnoDB 的表数据与索引数据是存储在一起的,都位于 B+ 数的叶子节点上,而 MyISAM 的表数据和索引数据是分开的。 - InnoDB 有安全的日志文件,这个日志文件用于恢复因数据库崩溃或其他情况导致的数据丢失问题,保证数据的一致性。
- InnoDB 和 MyISAM 支持的索引类型相同,但具体实现因为文件结构的不同有很大差异。
- 增删改查性能方面,果执行大量的增删改操作,推荐使用 InnoDB 存储引擎,它在删除操作时是对行删除,不会重建表。
MyISAM 和 InnoDB 存储引擎的对比
锁粒度方面:由于锁粒度不同,InnoDB 比 MyISAM 支持更高的并发;InnoDB 的锁粒度为行锁、MyISAM 的锁粒度为表锁、行锁需要对每一行进行加锁,所以锁的开销更大,但是能解决脏读和不可重复读的问题,相对来说也更容易发生死锁可恢复性上:由于 InnoDB 是有事务日志的,所以在产生由于数据库崩溃等条件后,可以根据日志文件进行恢复。而 MyISAM 则没有事务日志。查询性能上:MyISAM 要优于 InnoDB,因为 InnoDB 在查询过程中,是需要维护数据缓存,而且查询过程是先定位到行所在的数据块,然后在从数据块中定位到要查找的行;而 MyISAM 可以直接定位到数据所在的内存地址,可以直接找到数据。表结构文件上: MyISAM 的表结构文件包括:.frm(表结构定义),.MYI(索引),.MYD(数据);而 InnoDB 的表数据文件为:.ibd和.frm(表结构定义);
MySQL 基础架构
这道题应该从 MySQL 架构来理解,我们可以把 MySQL 拆解成几个零件,如下图所示
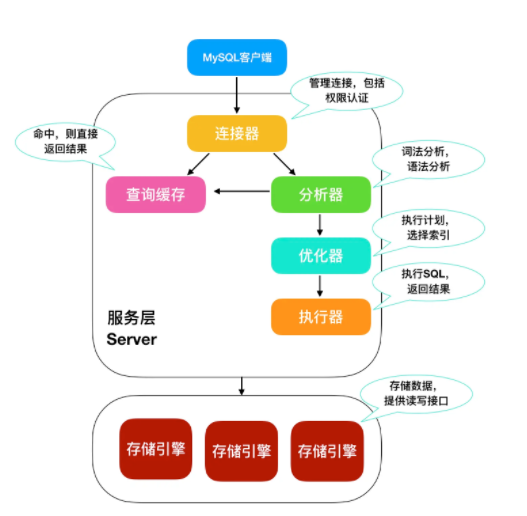
大致上来说,MySQL 可以分为 Server层和 存储引擎层。
Server 层包括连接器、查询缓存、分析器、优化器、执行器,包括大多数 MySQL 中的核心功能,所有跨存储引擎的功能也在这一层实现,包括 存储过程、触发器、视图等。
存储引擎层包括 MySQL 常见的存储引擎,包括 MyISAM、InnoDB 和 Memory 等,最常用的是 InnoDB,也是现在 MySQL 的默认存储引擎。存储引擎也可以在创建表的时候手动指定,比如下面
CREATE TABLE t (i INT) ENGINE = <Storage Engine>;
然后我们就可以探讨 MySQL 的执行过程了
连接器
首先需要在 MySQL 客户端登陆才能使用,所以需要一个连接器来连接用户和 MySQL 数据库,我们一般是使用
mysql -u 用户名 -p 密码
来进行 MySQL 登陆,和服务端建立连接。在完成 TCP 握手 后,连接器会根据你输入的用户名和密码验证你的登录身份。如果用户名或者密码错误,MySQL 就会提示 Access denied for user,来结束执行。如果登录成功后,MySQL 会根据权限表中的记录来判定你的权限。
查询缓存
连接完成后,你就可以执行 SQL 语句了,这行逻辑就会来到第二步:查询缓存。
MySQL 在得到一个执行请求后,会首先去 查询缓存 中查找,是否执行过这条 SQL 语句,之前执行过的语句以及结果会以 key-value 对的形式,被直接放在内存中。key 是查询语句,value 是查询的结果。如果通过 key 能够查找到这条 SQL 语句,就直接返回 SQL 的执行结果。
如果语句不在查询缓存中,就会继续后面的执行阶段。执行完成后,执行结果就会被放入查询缓存中。可以看到,如果查询命中缓存,MySQL 不需要执行后面的复杂操作,就可以直接返回结果,效率会很高。
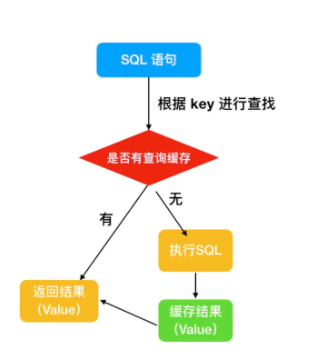
但是查询缓存不建议使用
为什么呢?因为只要在 MySQL 中对某一张表执行了更新操作,那么所有的查询缓存就会失效,对于更新频繁的数据库来说,查询缓存的命中率很低。
分析器
如果没有命中查询,就开始执行真正的 SQL 语句。
- 首先,MySQL 会根据你写的 SQL 语句进行解析,分析器会先做
词法分析,你写的 SQL 就是由多个字符串和空格组成的一条 SQL 语句,MySQL 需要识别出里面的字符串是什么,代表什么。 - 然后进行
语法分析,根据词法分析的结果, 语法分析器会根据语法规则,判断你输入的这个 SQL 语句是否满足 MySQL 语法。如果 SQL 语句不正确,就会提示 You have an error in your SQL syntax
优化器
经过分析器的词法分析和语法分析后,你这条 SQL 就合法了,MySQL 就知道你要做什么了。但是在执行前,还需要进行优化器的处理,优化器会判断你使用了哪种索引,使用了何种连接,优化器的作用就是确定效率最高的执行方案。
执行器4
MySQL 通过分析器知道了你的 SQL 语句是否合法,你想要做什么操作,通过优化器知道了该怎么做效率最高,然后就进入了执行阶段,开始执行这条 SQL 语句
在执行阶段,MySQL 首先会判断你有没有执行这条语句的权限,没有权限的话,就会返回没有权限的错误。如果有权限,就打开表继续执行。打开表的时候,执行器就会根据表的引擎定义,去使用这个引擎提供的接口。对于有索引的表,执行的逻辑也差不多。
至此,MySQL 对于一条语句的执行过程也就完成了。
SQL 的执行顺序
我们在编写一个查询语句的时候
SELECT DISTINCT
    < select_list >
FROM
    < left_table > < join_type >
JOIN < right_table > ON < join_condition >
WHERE
    < where_condition >
GROUP BY
    < group_by_list >
HAVING
    < having_condition >
ORDER BY
    < order_by_condition >
LIMIT < limit_number >
它的执行顺序你知道吗?这道题就给你一个回答。
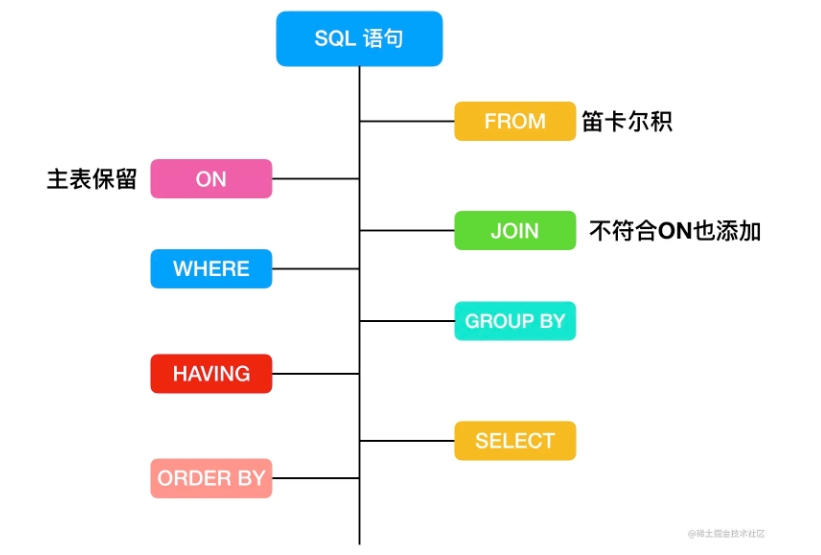
FROM 连接
首先,对 SELECT 语句执行查询时,对FROM 关键字两边的表执行连接,会形成笛卡尔积,这时候会产生一个虚表VT1(virtual table)
首先先来解释一下什么是
笛卡尔积现在我们有两个集合 A = {0,1} , B = {2,3,4}
那么,集合 A * B 得到的结果就是
A * B = {(0,2)、(1,2)、(0,3)、(1,3)、(0,4)、(1,4)};
B * A = {(2,0)、{2,1}、{3,0}、{3,1}、{4,0}、(4,1)};
上面 A B 和 B A 的结果就可以称为两个集合相乘的
笛卡尔积我们可以得出结论,A 集合和 B 集合相乘,包含了集合 A 中的元素和集合 B 中元素之和,也就是 A 元素的个数 * B 元素的个数
再来解释一下什么是虚表
在 MySQL 中,有三种类型的表
一种是
永久表,永久表就是创建以后用来长期保存数据的表一种是
临时表,临时表也有两类,一种是和永久表一样,只保存临时数据,但是能够长久存在的;还有一种是临时创建的,SQL 语句执行完成就会删除。一种是
虚表,虚表其实就是视图,数据可能会来自多张表的执行结果。
ON 过滤
然后对 FROM 连接的结果进行 ON 筛选,创建 VT2,把符合记录的条件存在 VT2 中。
JOIN 连接
第三步,如果是 OUTER JOIN(left join、right join) ,那么这一步就将添加外部行,如果是 left join 就把 ON 过滤条件的左表添加进来,如果是 right join ,就把右表添加进来,从而生成新的虚拟表 VT3。
WHERE 过滤
第四步,是执行 WHERE 过滤器,对上一步生产的虚拟表引用 WHERE 筛选,生成虚拟表 VT4。
WHERE 和 ON 的区别
- 如果有外部列,ON 针对过滤的是关联表,主表(保留表)会返回所有的列;
- 如果没有添加外部列,两者的效果是一样的;
应用
- 对主表的过滤应该使用 WHERE;
- 对于关联表,先条件查询后连接则用 ON,先连接后条件查询则用 WHERE;
GROUP BY
根据 group by 字句中的列,会对 VT4 中的记录进行分组操作,产生虚拟机表 VT5。果应用了group by,那么后面的所有步骤都只能得到的 VT5 的列或者是聚合函数(count、sum、avg等)。
HAVING
紧跟着 GROUP BY 字句后面的是 HAVING,使用 HAVING 过滤,会把符合条件的放在 VT6
SELECT
第七步才会执行 SELECT 语句,将 VT6 中的结果按照 SELECT 进行刷选,生成 VT7
DISTINCT
在第八步中,会对 TV7 生成的记录进行去重操作,生成 VT8。事实上如果应用了 group by 子句那么 distinct 是多余的,原因同样在于,分组的时候是将列中唯一的值分成一组,同时只为每一组返回一行记录,那么所以的记录都将是不相同的。
ORDER BY
应用 order by 子句。按照 order_by_condition 排序 VT8,此时返回的一个游标,而不是虚拟表。sql 是基于集合的理论的,集合不会预先对他的行排序,它只是成员的逻辑集合,成员的顺序是无关紧要的。
SQL 语句执行的过程如下
MySQL数据库索引
MySQL 基本存储结构
MySQL的基本存储结构是页(记录都存在页里边):
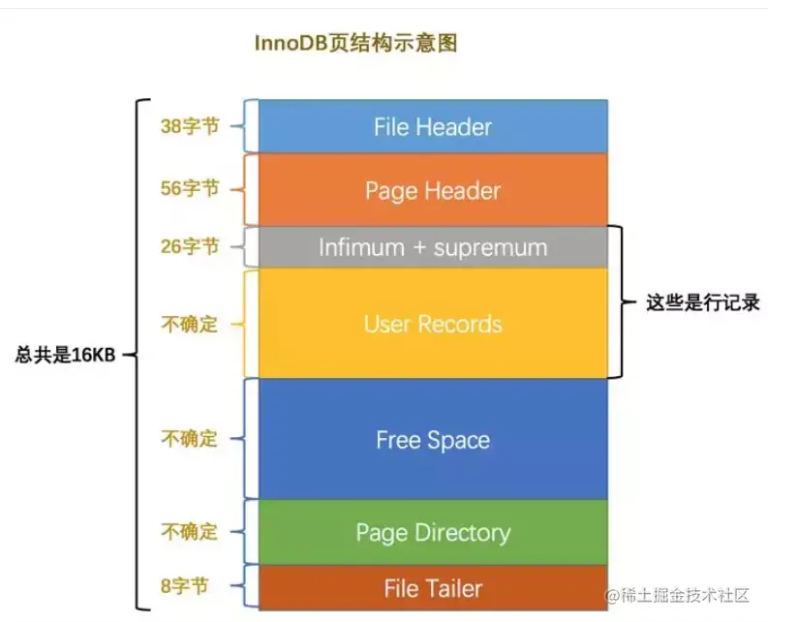

- 各个数据页可以组成一个双向链表
- 每个数据页中的记录又可以组成一个单向链表
- 每个数据页都会为存储在它里边儿的记录生成一个页目录,在通过主键查找某条记录的时候可以在页目录中使用二分法快速定位到对应的槽,然后再遍历该槽对应分组中的记录即可快速找到指定的记录
- 以其他列(非主键)作为搜索条件:只能从最小记录开始依次遍历单链表中的每条记录。
所以说,如果我们写select * from user where indexname = 'xxx'这样没有进行任何优化的sql语句,默认会这样做:
- 定位到记录所在的页:需要遍历双向链表,找到所在的页
- 从所在的页内中查找相应的记录:由于不是根据主键查询,只能遍历所在页的单链表了
很明显,在数据量很大的情况下这样查找会很慢!这样的时间复杂度为O(n)。
使用索引之后
索引做了些什么可以让我们查询加快速度呢?其实就是将无序的数据变成有序(相对):
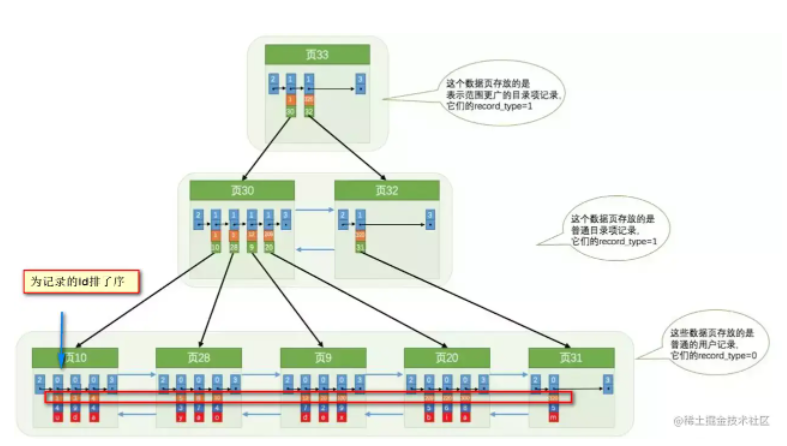
要找到id为8的记录简要步骤:
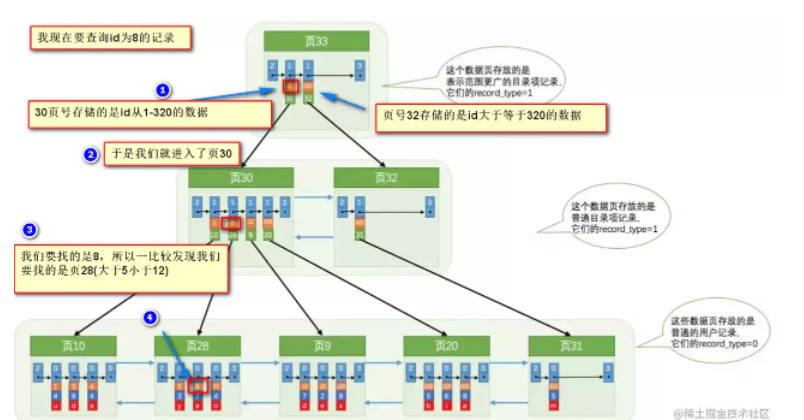
很明显的是:没有用索引我们是需要遍历双向链表来定位对应的页,现在通过 “目录” 就可以很快地定位到对应的页上了!(二分查找,时间复杂度近似为O(logn))
其实底层结构就是B+树,B+树作为树的一种实现,能够让我们很快地查找出对应的记录。
最左前缀原则
MySQL中的索引可以以一定顺序引用多列,这种索引叫作联合索引。如User表的name和city加联合索引就是(name,city)o而最左前缀原则指的是,如果查询的时候查询条件精确匹配索引的左边连续一列或几列,则此列就可以被用到。如下:
select * from user where name=xx and city=xx ; //可以命中索引
select * from user where name=xx ; // 可以命中索引
select * from user where city=xx; // 法命中索引
这里需要注意的是,查询的时候如果两个条件都用上了,但是顺序不同,如 city= xx and name =xx,那么现在的查询引擎会自动优化为匹配联合索引的顺序,这样是能够命中索引的.
由于最左前缀原则,在创建联合索引时,索引字段的顺序需要考虑字段值去重之后的个数,较多的放前面。ORDERBY子句也遵循此规则。
注意避免冗余索引
冗余索引指的是索引的功能相同,能够命中 就肯定能命中 ,那么 就是冗余索引如(name,city )和(name )这两个索引就是冗余索引,能够命中后者的查询肯定是能够命中前者的 在大多数情况下,都应该尽量扩展已有的索引而不是创建新索引。
MySQLS.7 版本后,可以通过查询 sys 库的 schemal_r dundant_indexes 表来查看冗余索引
Mysql如何为表字段添加索引
1.添加PRIMARY KEY(主键索引)
ALTER TABLE `table_name` ADD PRIMARY KEY ( `column` )
2.添加UNIQUE(唯一索引)
ALTER TABLE `table_name` ADD UNIQUE ( `column` )
3.添加INDEX(普通索引)
ALTER TABLE `table_name` ADD INDEX index_name ( `column` )
4.添加FULLTEXT(全文索引)
ALTER TABLE `table_name` ADD FULLTEXT ( `column`)
5.添加多列索引
ALTER TABLE `table_name` ADD INDEX index_name ( `column1`, `column2`, `column3` )
MySQL 常见索引类型
索引是存储在一张表中特定列上的数据结构,索引是在列上创建的。并且,索引是一种数据结构。
在 MySQL 中,主要有下面这几种索引
全局索引(FULLTEXT):全局索引,目前只有 MyISAM 引擎支持全局索引,它的出现是为了解决针对文本的模糊查询效率较低的问题。哈希索引(HASH):哈希索引是 MySQL 中用到的唯一 key-value 键值对的数据结构,很适合作为索引。HASH 索引具有一次定位的好处,不需要像树那样逐个节点查找,但是这种查找适合应用于查找单个键的情况,对于范围查找,HASH 索引的性能就会很低。B-Tree 索引:B 就是 Balance 的意思,BTree 是一种平衡树,它有很多变种,最常见的就是 B+ Tree,它被 MySQL 广泛使用。R-Tree 索引:R-Tree 在 MySQL 很少使用,仅支持 geometry 数据类型,支持该类型的存储引擎只有MyISAM、BDb、InnoDb、NDb、Archive几种,相对于 B-Tree 来说,R-Tree 的优势在于范围查找
MySQL 为什么采用 B+树作为索引
我们都知道MySQL存储的数据是在磁盘里,因为即使设备断电,放在磁盘的数据是不会有影响的,保障了数据不丢失,这意味着MySQL在磁盘上的数据是持久化的。
但数据存储在磁盘得到保障的同时也是有代价的,这代价就是磁盘的处理速度是毫秒级别的,相比内存纳秒级别的速度,简直是小巫见大巫。
索引虽然存储在磁盘上,但使用索引查找数据时,可以从磁盘先读取索引放到内存中,再通过索引从磁盘找到数据;再然后将磁盘读取到的数据也放到内存里。
索引就让磁盘和内存强强联手,趁机搭上了内存的车,感受了一把纳秒级别速度的推背感。
但是不管查询的过程中怎么优化,只要根还在磁盘,就避免不了会发生多次磁盘 I/O ,而磁盘 I/O 次数越多,消耗的时间也越多。
- 要尽少在磁盘做 I/O 操作。
但还有那么多的数据结构可选呢。
其实索引的需要发挥的目的已经决定了有哪些数据结构可选,那么就可以缩小选择其他数据结构的范围。
从为什么要建索引本身的首要目的出发。
- 要能尽快的按照区间高效地范围查找。
当然索引首要目的能支持高效范围查询,还要有插入更新等操作的动态数据结构。
如果使用哈希表
先看哈希表,哈希表对于我们来说太熟悉不过,哈希表的物理存储是一个数组,而数组在内存中是连续地址的空间。数据以Key、Value的方式存储。哈希表拥有精确的查询,所以时间复杂度是 O(1)。
而哈希表之所以能这么快是通过Key计算数组下标来快速找到Value。最简单的计算的方式是 余数法,通过先计算key的 HashCode,再通过哈希表的数组长度对 HashCode 求余,求余得出的余数就是数组下标,最后由下标访问到哈希表中存的Key、Value。
但是 Key 计算出的下标可能会有相同的情况,例如 HashCode 1010 对 6 取余是 2,但是HashCode 1112 对 6 取余也是 2。哈希算法随机计算出 HashCode 取余数组长度可能出现数组下标相同的情况,就是所谓的 哈希冲突。
而 哈希冲突 常用 链表 的方法解决。当发生 哈希冲突,相同下标的数据元素会替换成存储指针,而不同Key 的数据元素添加到链表中。查找时通过指针遍历这个链表,再匹配出正确的 Key 就可以
那么如果哈希表用来做成索引,当进行范围查询时意味着要全部扫描。但类似 Redis 存储形式是 KV 的NoSQL数据库,会适合等值查询的场景,不过这是题外话。
如果使用跳表
接着我们来看跳表。跳表似乎对于我们来说是一个比较陌生的数据结构,但是在Redis中却是比较常用的数据结构之一。跳表底层实质就是可以进行二分查找的有序链表。而且在链表基础加上索引层。即能支持插入、删除等动态操作,也支持按区间高效查询。而且不管是查找、插入、删除对应的时间复杂度都是 O(logn)
跳表是在链表基础上加了索引层。可以起到支持区间查询的作用
当数据量大时,一个包含多个结点的链表,在建立了五级索引后可以突显的看到索引层的优势。同时注意道这样一个规律 “加一层索引,查询所需要遍历的节点个数减少,查询效率也就提高了。跳表似乎也很适合用来作为索引的数据结构。但是不要忘了还有首个条件没满足,就是 "要尽少在磁盘做 I/O 操作。" 而跳表显然没能满足这一条件,跳表在随数据量增多的情况,索引层也会随着增高,相应的就会增加读取IO的次数,从而影响性能。
那么我们回到 “那么多数据结构,为什么选树结构的问题?”我们发现哈希表和跳表并不能很好的满足解决磁盘痛点和索引目的的这两个主要条件。那么我们来看为什么要来选树结构。
树结构
而树结构其特性决定了遍历数据方式本身就纯天然的支持按区间查询。再加上树是非线性结构的优势相比于线性结构的数组,不必像数组的数据是连续存放的。那么当树结构在插入新数据时就不用像数组插入数据前时,需要将数据所在往后的所有数据节点都得往后挪动的开销。所以树结构更适合插入更新等动态操作的数据结构。
树结构在满足了索引目的和其他条件的情况下,至于减少磁盘查询操作的痛点其实我们就可以在基于树结构的数据结构中去选择。
为什么偏偏采用 B+ 树作为索引
那么多的树结构中,除了B+树,你还会想到哪些树结构?二叉树查找树、自平衡二叉树、B树。
二叉查找树
二叉查找树不同于普通二叉查找树,是将小于根节点的元素放在左子树,而右子树正好相反是放大于根节点的元素。(说白了就是根节点是左子树和右子树的中位数,左边放小于中位数的,右边放大于中位数,这不就是二分查找算法的奥义)
二叉树也有明显弊端,在极端情况下,如果每次插入的数据都是最小或者都是最大的元素,那么树结构会退化成一条链表。查询数据是的时间复杂度就会是O(n)
自平衡二叉树
自平衡二叉树就是来解决二叉查找树极端下退化成链表的问题,自平衡二叉树也称 平衡二叉查找树(AVL树)。
(你可以看到从简单的二叉树,一步步演化到二分查找树再到现在的自平衡二叉树。一个简单的东西慢慢的逐渐走向复杂。如果只知道答案,我们是不会知道来龙去脉的。)
平衡二叉查找树其实主要就是在二叉查找树的基础上加上约束:让每个节点的左右子树高度差不能超过 1。那么这样让可以让左右子树都保持平衡,让查询数据操作的时间复杂度在 O(logn)。
平衡二叉查找树将每次插入的元素数据都会维持自平衡
但是不管自平衡树是平衡二叉查找树还是红黑树,都会随着插入的元素增多,而导致树的高度变高,这同样意味着磁盘 I/O 操作次数多,影响到整体查询的效率。
B树
我们平时看到 B+树 还有 B-树,不免就会将 B-树 读成 "B减树" ,但 B-树 其 - 横线只是连接符,所以 B-树 就是称为 B树。
自平衡二叉树虽然查找的时间复杂度在O(logn),前面也说过它本身是一个二叉树,每个节点只能有2个子节点,那么随着数据量增大的时候,节点个数越多,树高度也会增高(也就是树的深度越深),增加磁盘I/O次数,影响查询效率。
那么你如果从树形结构的二叉树这一路的进阶过程中可以看到,二叉树每一次为了解决一个新的问题都会创造出新的 bug (或者创造一个又个的痛点)。
看到这就不难猜到,B树的出现可以解决树高度的问题。之所以是B树,而并不是名称中"xxx二叉树",就是它不再限制一个父节点中只能有两个子节点,而是允许 M 个子节点(M > 2)。不仅如此,B树的一个节点可以存储多个元素,相比较于前面的那些二叉树数据结构又将整体的树高度降低了。
B 树的节点可以包含有多个字节点,所以 B树是一棵多叉树,它的每一个节点包含的最多子节点数量的称为B树的阶。如下图是一颗3阶的B树。
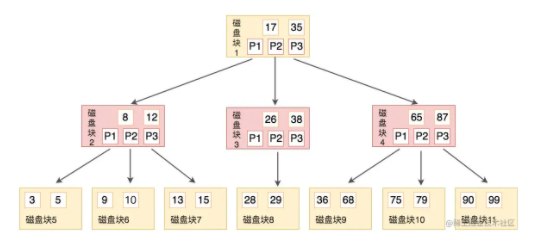
上图中每一个节点称为页,在mysql中数据读取的基本单位是页,而页就是我们上面所说的磁盘块。磁盘块中的p节点是指向子节点的指针。指针在树结构中都有,在前面的二叉树中也都是有的。
那我们来看一下上图所示,当一颗3阶的B树查找 90 这个的元素时的流程是怎么样的?
先从根节点出发,也就是 磁盘块1,判断 90 在17 ~ 35之间,通过磁盘块1中的指针 p3 找到磁盘块4。还是按照原来的步骤,在磁盘块4中的65 ~ 87之间相比较,最后磁盘4的指针p3找到磁盘块11。也就找到有匹配90的键值。
可以发现一颗3阶的B树在查找叶子节点时,由于树高度只有 3,所以查找过程最多只需要3次的磁盘I/O操作。
数据量不大时可能不太真切。但当数据量大时,节点也会随着增多;此时如果还是前面的自平衡二叉树的场景下,由于二叉树只能最多2个叶子节点的约束,也只能纵向去的去扩展子节点,树的高度会很高,意味着需要更多的操作磁盘I/O次数。而B树则可以通过横向扩展节点从而降低树的高度,所以效率自然要比二叉树效率更高。(直白说就是变矮胖了)
看到这,相信你也知道如果B树这么适合,也就没有接下来B+树的什么事了。
接着,那为什么不用B树,而用了B+树呢?
你看啊,B树其实已经满足了我们最前面所要满足的条件,减少磁盘I/O操作,同时支持按区间查找。但注意,虽然B树支持按区间查找,但并不高效。例如上面的例子中,B树能高效的通过等值查询 90 这个值,但不方便查询出一个期间内3 ~ 10区间内所有数的结果。因为当B树做范围查询时需要使用中序遍历,那么父节点和子节点也就需要不断的来回切换涉及了多个节点会给磁盘I/O带来很多负担。
B+树
B+树从 + 的符号可以看出是B树的升级版,MySQL 中innoDB引擎中的索引底层数据结构采用的正是 B+树。
B+树相比于B树,做了这样的升级:B+树中的非叶子节点都不存储数据,而是只作为索引。由叶子节点存放整棵树的所有数据。而叶子节点之间构成一个从小到大有序的链表互相指向相邻的叶子节点,也就是叶子节点之间形成了有序的双向链表。如下图B+树的结构。
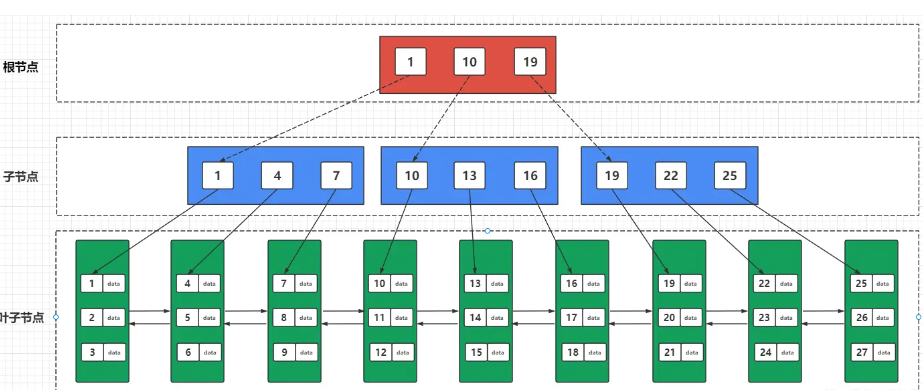
(B+树是不是有点像前面的跳表,数据底层是数据,上层都是按底层区间构成的索引层,只不过它不像跳表是纵向扩展,而是横向扩展的“跳表”。这么做的好处即减少磁盘的IO操作又提高了范围查找的效率。)
接着再来看B+树的插入和删除,B+树做了大量冗余节点,从上面可以发现父节点的所有元素都会在子节点中出现,这样当删除一个节点时,可以直接从叶子节点中删除,这样效率更快。
B树相比于B+树,B树没有冗余节点,删除节点时会发生复杂的树变形,而B+树有冗余节点,不会涉及到复杂的树变形。而且B+树的插入也是如此,最多只涉及树的一条分支路径。B+树也不用更多复杂算法,可以类似黑红树的旋转去自动平衡。
什么是 内连接、外连接、交叉连接、笛卡尔积
连接的方式主要有三种:外连接、内链接、交叉连接
外连接(OUTER JOIN):外连接分为三种,分别是左外连接(LEFT OUTER JOIN 或 LEFT JOIN)、右外连接(RIGHT OUTER JOIN 或 RIGHT JOIN)、全外连接(FULL OUTER JOIN 或 FULL JOIN)左外连接:又称为左连接,这种连接方式会显示左表不符合条件的数据行,右边不符合条件的数据行直接显示 NULL
右外连接:也被称为右连接,他与左连接相对,这种连接方式会显示右表不符合条件的数据行,左表不符合条件的数据行直接显示 NULL
MySQL 暂不支持全外连接
内连接(INNER JOIN):结合两个表中相同的字段,返回关联字段相符的记录。
笛卡尔积(Cartesian product): 我在上面提到了笛卡尔积,为了方便,下面再列出来一下。
现在我们有两个集合 A = {0,1} , B = {2,3,4}
那么,集合 A * B 得到的结果就是
A * B = {(0,2)、(1,2)、(0,3)、(1,3)、(0,4)、(1,4)};
B * A = {(2,0)、{2,1}、{3,0}、{3,1}、{4,0}、(4,1)};
上面 A B 和 B A 的结果就可以称为两个集合相乘的
笛卡尔积我们可以得出结论,A 集合和 B 集合相乘,包含了集合 A 中的元素和集合 B 中元素之和,也就是 A 元素的个数 * B 元素的个数
交叉连接的原文是
Cross join,就是笛卡尔积在 SQL 中的实现,SQL中使用关键字CROSS JOIN来表示交叉连接,在交叉连接中,随便增加一个表的字段,都会对结果造成很大的影响。SELECT * FROM t_Class a CROSS JOIN t_Student b WHERE a.classid=b.classid或者不用 CROSS JOIN,直接用 FROM 也能表示交叉连接的效果
SELECT * FROM t_Class a ,t_Student b WHERE a.classid=b.classid如果表中字段比较多,不适宜用交叉连接,交叉连接的效率比较差。
全连接:全连接也就是
full join,MySQL 中不支持全连接,但是可以使用其他连接查询来模拟全连接,可以使用UNION和UNION ALL进行模拟。例如(select colum1,colum2...columN from tableA ) union (select colum1,colum2...columN from tableB )
或
(select colum1,colum2...columN from tableA ) union all (select colum1,colum2...columN from tableB );使用 UNION 和 UNION ALL 的注意事项
通过 union 连接的 SQL 分别单独取出的列数必须相同
使用 union 时,多个相等的行将会被合并,由于合并比较耗时,一般不直接使用 union 进行合并,而是通常采用 union all 进行合并
Oracle和Mysql的区别
在Mysql中,一个用户下可以创建多个库:
而在Oracle中,Oracle服务器是由两部分组成
- 数据库实例【理解为对象,看不见的】
- 数据库【理解为类,看得见的】
一个数据库实例可拥有多个用户,一个用户默认拥有一个表空间。
表空间是存储我们数据库表的地方,表空间内可以有多个文件。
当我们使用Oracle作为我们数据库时,我们需要指定用户、表空间来存储我们所需要的数据!
MongoDB
MongoDB是基于分布式文件存储的数据库,由C++语言编写。旨在为WEB应用提供可扩展的高性能数据存储解决方案,且MongodDB是一个介于关系数据库与非关系数据库之间的产品,是非关系型数据库中功能最丰富,最像关系数据库。
由于MongoDB的特性以及功能,使得其在企业使用频率很大,所以很多面试都会MongoDB的相关知识,基于网上以及自己阅读官网文档总结2019-2020年MongoDB的面试题。具体如下:
MongoDB的优势有哪些?
- 面向集合(
Collection)和文档(document)的存储,以JSON格式的文档保存数据。 - 高性能,支持
Document中嵌入Document减少了数据库系统上的I/O操作以及具有完整的索引支持,支持快速查询 - 高效的传统存储方式:支持二进制数据及大型对象
- 高可用性,数据复制集,MongoDB 数据库支持服务器之间的数据复制来提供自动故障转移(
automatic failover) - 高可扩展性,分片(
sharding)将数据分布在多个数据中心,MongoDB支持基于分片键创建数据区域. - 丰富的查询功能, 聚合管道(
Aggregation Pipeline)、全文搜索(Text Search)以及地理空间查询(Geospatial Queries) - 支持多个存储引擎,WiredTiger存储引、In-Memory存储引擎
MongoDB 支持哪些数据类型?
java类似数据类型:
| 类型 | 解析 |
|---|---|
String | 字符串。存储数据常用的数据类型。在 MongoDB 中,UTF-8 编码的字符串才是合法的 |
Integer | 整型数值。用于存储数值。根据你所采用的服务器,可分为 32 位或 64 位 |
Double | 双精度浮点值。用于存储浮点值 |
Boolean | 布尔值。用于存储布尔值(真/假) |
Arrays | 用于将数组或列表或多个值存储为一个键 |
Datetime | 记录文档修改或添加的具体时间 |
MongoDB特有数据类型:
| 类型 | 解析 |
|---|---|
ObjectId | 用于存储文档 id,ObjectId是基于分布式主键的实现MongoDB分片也可继续使用 |
Min/Max Keys | 将一个值与 BSON(二进制的 JSON)元素的最低值和最高值相对比 |
Code | 用于在文档中存储 JavaScript代码 |
Regular Expression | 用于在文档中存储正则表达式 |
Binary Data | 二进制数据。用于存储二进制数据 |
Null | 用于创建空值 |
Object | 用于内嵌文档 |
什么是集合Collection、文档Document,以及与关系型数据库术语类比。
- 集合
Collection位于单独的一个数据库MongoDB 文档Document集合,它类似关系型数据库(RDBMS)中的表Table。一个集合Collection内的多个文档Document可以有多个不同的字段。通常情况下,集合Collection中的文档Document有着相同含义。 - 文档
Document由key-value构成。文档Document是动态模式,这说明同一集合里的文档不需要有相同的字段和结构。类似于关系型数据库中table中的每一条记录。 - 与关系型数据库术语类比
| mongodb | 关系型数据库 |
|---|---|
| Database | Database |
| Collection | Table |
| Document | Record/Row |
| Filed | Column |
| Embedded Documents | Table join |
什么是”Mongod“,以及MongoDB命令
mongod是处理MongoDB系统的主要进程。它处理数据请求,管理数据存储,和执行后台管理操作。当我们运行mongod命令意味着正在启动MongoDB进程,并且在后台运行。
MongoDB命令:
| 命令 | 说明 |
|---|---|
| use database_name | 切换数据库 |
| db.myCollection.find().pretty() | 格式化打印结果 |
| db.getCollection(collectionName).find() | 修改Collection名称 |
"Mongod"默认参数有?
- 传递数据库存储路径,默认是
"/data/db" - 端口号 默认是 "27017"
MySQL和mongodb的区别
| 形式 | MongoDB | MySQL |
|---|---|---|
| 数据库模型 | 非关系型 | 关系型 |
| 存储方式 | 虚拟内存+持久化 | |
| 查询语句 | 独特的MongoDB查询方式 | 传统SQL语句 |
| 架构特点 | 副本集以及分片 | 常见单点、M-S、MHA、MMM等架构方式 |
| 数据处理方式 | 基于内存,将热数据存在物理内存中,从而达到高速读写 | 不同的引擎拥有自己的特点 |
| 使用场景 | 事件的记录,内容管理或者博客平台等数据大且非结构化数据的场景 | 适用于数据量少且很多结构化数据 |
mongodb和redis区别以及选择原因
| 形式 | MongoDB | redis |
|---|---|---|
| 内存管理机制 | MongoDB 数据存在内存,由 linux系统 mmap 实现,当内存不够时,只将热点数据放入内存,其他数据存在磁盘 | Redis 数据全部存在内存,定期写入磁盘,当内存不够时,可以选择指定的 LRU 算法删除数据 |
| 支持的数据结构 | MongoDB 数据结构比较单一,但是支持丰富的数据表达,索引 | Redis 支持的数据结构丰富,包括hash、set、list等 |
| 性能 | mongodb依赖内存,TPS较高 | Redis依赖内存,TPS非常高。性能上Redis优于MongoDB |
| 可靠性 | 支持持久化以及复制集增加可靠性 | Redis依赖快照进行持久化;AOF增强可靠性;增强可靠性的同时,影响访问性能 |
| 数据分析 | mongodb内置数据分析功能(mapreduce) | Redis不支持 |
| 事务支持情况 | 只支持单文档事务,需要复杂事务支持的场景暂时不适合 | Redis 事务支持比较弱,只能保证事务中的每个操作连续执行 |
| 集群 | MongoDB 集群技术比较成熟 | Redis从3.0开始支持集群 |
选择原因:
- 架构简单
- 没有复杂的连接
- 深度查询能力,
MongoDB支持动态查询。 - 容易调试
- 容易扩展
- 不需要转化/映射应用对象到数据库对象
- 使用内部内存作为存储工作区,以便更快的存取数据。
如何执行事务/加锁?
mongodb没有使用传统的锁或者复杂的带回滚的事务,因为它设计的宗旨是轻量,快速以及可预计的高性能.可以把它类比成mysql mylsam的自动提交模式.通过精简对事务的支持,性能得到了提升,特别是在一个可能会穿过多个服务器的系统里.
更新操作会立刻fsync到磁盘?
不会,磁盘写操作默认是延迟执行的.写操作可能在两三秒(默认在60秒内)后到达磁盘,通过 syncPeriodSecs 启动参数,可以进行配置.例如,如果一秒内数据库收到一千个对一个对象递增的操作,仅刷新磁盘一次.
MongoDB索引
索引类型有哪些?
- 单字段索引(
Single Field Indexes) - 复合索引(
Compound Indexes) - 多键索引(
Multikey Indexes) - 全文索引(
text Indexes) - Hash 索引(
Hash Indexes) - 通配符索引(
Wildcard Index) - 2dsphere索引(
2dsphere Indexes)
MongoDB在A:{B,C}上建立索引,查询A:{B,C}和A:{C,B}都会使用索引吗?
由于MongoDB索引使用B-tree树原理,只会在A:{B,C}上使用索引
MongoDB索引详情可看文章【MongoDB系列--轻松应对面试中遇到的MongonDB索引(index)问题】,其中包括很多索引的问题:
- 创建索引,需要考虑的问题
- 索引限制问题
- 索引类型详细解析
- 索引的种类问题
什么是聚合
聚合操作能够处理数据记录并返回计算结果。聚合操作能将多个文档中的值组合起来,对成组数据执行各种操作,返回单一的结果。它相当于 SQL 中的 count(*) 组合 group by。对于 MongoDB 中的聚合操作,应该使用aggregate()方法。
详情可查看文章【MongoDB系列--深入理解MongoDB聚合(Aggregation)】,其中包括很多聚合的问题:
- 聚合管道(
aggregation pipeline)的问题 Aggregation Pipeline优化等问题- Map-Reduce函数的问题
MongoDB分片
monogodb 中的分片sharding
分片sharding是将数据水平切分到不同的物理节点。当应用数据越来越大的时候,数据量也会越来越大。当数据量增长 时,单台机器有可能无法存储数据或可接受的读取写入吞吐量。利用分片技术可以添加更多的机器来应对数据量增加 以及读写操作的要求。
分片(Shard)和复制(replication)是怎样工作的?
每一个分片(shard)是一个分区数据的逻辑集合。分片可能由单一服务器或者集群组成,我们推荐为每一个分片(shard)使用集群。
如果块移动操作(moveChunk)失败了,我需要手动清除部分转移的文档吗?
不需要,移动操作是一致(consistent)并且是确定性的(deterministic)。
- 一次失败后,移动操作会不断重试。
- 当完成后,数据只会出现在新的分片里(shard)
数据在什么时候才会扩展到多个分片(Shard)里?
MongoDB 分片是基于区域(range)的。所以一个集合(collection)中的所有的对象都被存放到一个块(chunk)中,默认块的大小是 64Mb。当数据容量超过64 Mb,才有可能实施一个迁移,只有当存在不止一个块的时候,才会有多个分片获取数据的选项。
更新一个正在被迁移的块(Chunk)上的文档时会发生什么?
更新操作会立即发生在旧的块(Chunk)上,然后更改才会在所有权转移前复制到新的分片上。
如果一个分片(Shard)停止或很慢的时候,发起一个查询会怎样?
如果一个分片停止了,除非查询设置了 “Partial” 选项,否则查询会返回一个错误。如果一个分片响应很慢,MongoDB 会等待它的响应。
MongoDB复制集
MongoDB副本集实现高可用的原理
MongoDB 使用了其复制(Replica Set)方案,实现自动容错机制为高可用提供了基础。目前,MongoDB 支持两种复制模式:
Master/Slave,主从复制,角色包括Master和Slave。Replica Set,复制集复制,角色包括Primary和Secondary以及Arbiter。(生产环境必选)
什么是master或primary?
副本集只能有一个主节点能够确认写入操作来接收所有写操作,并记录其操作日志中的数据集的所有更改(记录在oplog中)。在集群中,当主节点(master)失效,Secondary节点会变为master
什么是Slave或Secondary?
复制主节点的oplog并将oplog记录的操作应用于其数据集,如果主节点宕机了,将从符合条件的从节点选举选出新的主节点。
什么是Arbiter?
仲裁节点不维护数据集。 仲裁节点的目的是通过响应其他副本集节点的心跳和选举请求来维护副本集中的仲裁
复制集节点类型有哪些?
- 优先级0型(
Priority 0)节点 - 隐藏型(
Hidden)节点 - 延迟型(
Delayed)节点 - 投票型(
Vote)节点以及不可投票节点
启用备份故障恢复需要多久?
从备份数据库声明主数据库宕机到选出一个备份数据库作为新的主数据库将花费10到30秒时间.这期间在主数据库上的操作将会失败–包括写入和强一致性读取(strong consistent read)操作.然而,你还能在第二数据库上执行最终一致性查询(eventually consistent query)(在slaveok模式下),即使在这段时间里.
MongoDB复制详解分析可查看文章【MongoDB系列-解决面试中可能遇到的MongoDB复制集(replica set)问题】
raft选举过程,投票规则?
选举过程:
当系统启动好之后,初始选举后系统由1个Leader和若干个Follower角色组成。然后突然由于某个异常原因,Leader服务出现了异常,导致Follower角色检测到和Leader的上次RPC更新时间超过给定阈值时间时。此时Follower会认为Leader服务已出现异常,然后它将会发起一次新的Leader选举行为,同时将自身的状态从Follower切换为Candidate身份。随后请求其它Follower投票选择自己。
投票规则:
- 当一个候选人获得了同一个任期号内的大多数选票,就成为领导人。
- 每个节点最多在一个任期内投出一张选票。并且按照先来先服务的原则。
- 一旦候选人赢得选举,立刻成为领导,并发送心跳维持权威,同时阻止新领导人的诞生
可查看文章【通俗易懂的Paxos算法-基于消息传递的一致性算法】
在哪些场景使用MongoDB?
规则: 如果业务中存在大量复杂的事务逻辑操作,则不要用MongoDB数据库;在处理非结构化 / 半结构化的大数据使用MongoDB,操作的数据类型为动态时也使用MongoDB,比如:
- 内容管理系统,切面数据、日志记录
- 移动端
Apps:O2O送快递骑手、快递商家的信息(包含位置信息) - 数据管理,监控数据
GeoJson使用
概述 MongoDB支持以下类型的GeoJSON对象类型:
- 点(Point)
- 线(LineString)
- 多边形(Polygon)
- 多点(MultiPoint)
- 多线(MultiLineString)
- 多个多边形(MultiPolygon)
- 几何集合(GeometryCollection)
要存储GeoJSON数据的话,在文档中使用 type字段来指定GeoJSON对象类型以及 coordinates 对象来指定对象的坐标:
{ type: "<GeoJSON type>" , coordinates: <coordinates> }
//示例
{ "type": "Point", "coordinates": [lon(经度),lat(纬度)]}
一般以经度、纬度的顺序来排列坐标
- 有效的经度值在-180和180之间(包括两端值)
- 有效的纬度值在-90和90之间(包括两端值)
MongoDB默认使用WGS84基准作为GeoJSON默认的坐标参考系统。
点(Point) 示例如下:
{ type: "Point", coordinates: [ 40, 5 ] }
线(LineString) 对于LineString类型, coordinate 成员必须是两个或多个坐标的数组。示例如下:
{ type: "LineString", coordinates: [ [ 40, 5 ], [ 41, 6 ] ] }
一个线性环由4个或更多坐标构成。第一个和最后一个坐标相等(它们表示相同的坐标)。尽管线性环没有被显式表示为一个GeoJSON几何类型,但是它在多边形几何类型定义中有提及到。
多边形(Polygon) 多边形由一个GeoJSON线性环坐标数组的数组组成。这些线性环闭合的线段。闭合的线段至少有4个坐标对,并且第一个坐标和最后一个坐标相同。 一个弯曲平面上两个点组成的线不一定等同于在一个平面上这两个点确定的线。在弯曲平面上两个点连接的线是测地线。仔细检查点的坐标,以避免共边、重合以及其它交叉类型的错误。
单环多边形 下面的示例展示了一个外环的GeoJSON多边形,不包括内环(或者小洞)。第一个和最后一个坐标必须相同以关闭这个多边形。
{
type: "Polygon",
coordinates: [ [ [ 0 , 0 ] , [ 3 , 6 ] , [ 6 , 1 ] , [ 0 , 0 ] ] ]
}
对于单环的多边形,这个环不能自交叉。
多环多边形 对于多环多边形:
第一个描述的环必须是外环 外环不能自交叉 所有内环必须全部包含在外环中 内环之间不能交叉或覆盖。内环不能共边 下面的示例表示了包含一个内环的GeoJSON多边形:
{
type : "Polygon",
coordinates : [
[ [ 0 , 0 ] , [ 3 , 6 ] , [ 6 , 1 ] , [ 0 , 0 ] ],
[ [ 2 , 2 ] , [ 3 , 3 ] , [ 4 , 2 ] , [ 2 , 2 ] ]
]
}
多点(MultiPoint) GeoJSON多点嵌入文档包含一系列点。
{
type: "MultiPoint",
coordinates: [
[ -73.9580, 40.8003 ],
[ -73.9498, 40.7968 ],
[ -73.9737, 40.7648 ],
[ -73.9814, 40.7681 ]
]
}

12345678910
多线(MultiLineString) 示例如下:
{
type: "MultiLineString",
coordinates: [
[ [ -73.96943, 40.78519 ], [ -73.96082, 40.78095 ] ],
[ [ -73.96415, 40.79229 ], [ -73.95544, 40.78854 ] ],
[ [ -73.97162, 40.78205 ], [ -73.96374, 40.77715 ] ],
[ [ -73.97880, 40.77247 ], [ -73.97036, 40.76811 ] ]
]
多个多边形(MultiPolygon) 示例如下:
{
type: "MultiPolygon",
coordinates: [
[ [ [ -73.958, 40.8003 ], [ -73.9498, 40.7968 ], [ -73.9737, 40.7648 ], [ -73.9814, 40.7681 ], [ -73.958, 40.8003 ] ] ],
[ [ [ -73.958, 40.8003 ], [ -73.9498, 40.7968 ], [ -73.9737, 40.7648 ], [ -73.958, 40.8003 ] ] ]
]
}
几何集合(GeometryCollection) GeoJSON类型GeometryCollection的存储示例如下:
{
type: "GeometryCollection",
geometries: [
{
type: "MultiPoint",
coordinates: [
[ -73.9580, 40.8003 ],
[ -73.9498, 40.7968 ],
[ -73.9737, 40.7648 ],
[ -73.9814, 40.7681 ]
]
},
{
type: "MultiLineString",
coordinates: [
[ [ -73.96943, 40.78519 ], [ -73.96082, 40.78095 ] ],
[ [ -73.96415, 40.79229 ], [ -73.95544, 40.78854 ] ],
[ [ -73.97162, 40.78205 ], [ -73.96374, 40.77715 ] ],
[ [ -73.97880, 40.77247 ], [ -73.97036, 40.76811 ] ]
]
}
]
}
geojson点集合中查找最大,最小坐标值
我的用例非常简单:我在mongodb中有一个文档集合,其地理坐标指定为GeoJSON Point。
我想找到此集合的边界框,定义为lat min,long min,lat max,long max。
这些文件具有以下结构:
{
 "_id": ObjectId("538ed354b83897b4418b4567"),
 "name":"example point",
 "description":"",
 "location": {
   "type":"Point",
   "coordinates": [
      24.501885327447624,
      42.228924279974158
    ]
  },
 "status":"1",
 "type":"image"
}
找到了两种不错的工作方法,它们适用于具有键/值对的子文档(数组),但是到目前为止,我还没有找到任何简单的数组,如GeoJSON坐标对。
使用聚合时,我遇到了一个问题,即我无法从GeoJSON点提取X,Y坐标(使用$slice: [0,1]和$slice: [1,1]进行了尝试,但这在$project管道中似乎不起作用)。放松似乎也不是正确的方法。
对于在RDMS中真正基本的查询,Map / reduce看起来有些过大。
正确的方法是$unwind,因为"切片"和"位置投影"目前对于$project或$group均无效。 因此,MongoDB 2.6版本中确实没有提供任何新方法可以改变这种方法:
但是实际上,您需要两个$group阶段,以便从"坐标"数组中获取$first和$last,然后将它们传递给$min和$max:
db.geoobj.aggregate([
    {"$unwind":"$location.coordinates" },
    {"$group": {
       "_id":"$_id",
       "lat": {"$first":"$location.coordinates" },
       "lon": {"$last":"$location.coordinates" }
    }},
    {"$group": {
       "_id": null,
       "minLat": {"$min":"$lat" },
       "minLon": {"$min":"$lon" },
       "maxLat": {"$max":"$lat" },
       "maxLon": {"$max":"$lon" }
    }}
])
这将产生四个坐标,分别代表集合的最小和最大点范围。 您可能会更喜欢,并使用$map这样的运算符将其转换为"多边形"表示形式,但这确实是另一个问题。
在GeoJSON中,坐标按(经度,纬度)顺序排列,而不是传统的表示法(例如 谷歌地图使用。 只需在分组阶段1交换lat和lon就可以了
PostgreSql
PostgreSQL 是一个免费的对象-关系数据库服务器(ORDBMS),在灵活的BSD许可证下发行。
PostgreSQL 开发者把它念作 post-gress-Q-L。
PostgreSQL 的 Slogan 是 "世界上最先进的开源关系型数据库"。
参考内容:PostgreSQL 10.1 手册
什么是数据库?
数据库(Database)是按照数据结构来组织、存储和管理数据的仓库。
每个数据库都有一个或多个不同的 API 用于创建,访问,管理,搜索和复制所保存的数据。
我们也可以将数据存储在文件中,但是在文件中读写数据速度相对较慢。
所以,现在我们使用关系型数据库管理系统(RDBMS)来存储和管理的大数据量。所谓的关系型数据库,是建立在关系模型基础上的数据库,借助于集合代数等数学概念和方法来处理数据库中的数据。
ORDBMS(对象关系数据库系统)是面向对象技术与传统的关系数据库相结合的产物,查询处理是 ORDBMS 的重要组成部分,它的性能优劣将直接影响到DBMS 的性能。
ORDBMS在原来关系数据库的基础上,增加了一些新的特性。
RDBMS 是关系数据库管理系统,是建立实体之间的联系,最后得到的是关系表。
OODBMS 面向对象数据库管理系统,将所有实体都看着对象,并将这些对象类进行封装,对象之间的通信通过消息 OODBMS 对象关系数据库在实质上还是关系数据库 。
ORDBMS 术语
在我们开始学习 PostgreSQL 数据库前,让我们先了解下 ORDBMS 的一些术语:
- 数据库: 数据库是一些关联表的集合。
- 数据表: 表是数据的矩阵。在一个数据库中的表看起来像一个简单的电子表格。
- 列: 一列(数据元素) 包含了相同的数据, 例如邮政编码的数据。
- 行:一行(=元组,或记录)是一组相关的数据,例如一条用户订阅的数据。
- 冗余:存储两倍数据,冗余降低了性能,但提高了数据的安全性。
- 主键:主键是唯一的。一个数据表中只能包含一个主键。你可以使用主键来查询数据。
- 外键:外键用于关联两个表。
- 复合键:复合键(组合键)将多个列作为一个索引键,一般用于复合索引。
- 索引:使用索引可快速访问数据库表中的特定信息。索引是对数据库表中一列或多列的值进行排序的一种结构。类似于书籍的目录。
- 参照完整性: 参照的完整性要求关系中不允许引用不存在的实体。与实体完整性是关系模型必须满足的完整性约束条件,目的是保证数据的一致性。
PostgreSQL 特征
函数:通过函数,可以在数据库服务器端执行指令程序。
索引:用户可以自定义索引方法,或使用内置的 B 树,哈希表与 GiST 索引。
触发器:触发器是由SQL语句查询所触发的事件。如:一个INSERT语句可能触发一个检查数据完整性的触发器。触发器通常由INSERT或UPDATE语句触发。 多版本并发控制:PostgreSQL使用多版本并发控制(MVCC,Multiversion concurrency control)系统进行并发控制,该系统向每个用户提供了一个数据库的"快照",用户在事务内所作的每个修改,对于其他的用户都不可见,直到该事务成功提交。
规则:规则(RULE)允许一个查询能被重写,通常用来实现对视图(VIEW)的操作,如插入(INSERT)、更新(UPDATE)、删除(DELETE)。
数据类型:包括文本、任意精度的数值数组、JSON 数据、枚举类型、XML 数据
等。
全文检索:通过 Tsearch2 或 OpenFTS,8.3版本中内嵌 Tsearch2。
NoSQL:JSON,JSONB,XML,HStore 原生支持,至 NoSQL 数据库的外部数据包装器。
数据仓库:能平滑迁移至同属 PostgreSQL 生态的 GreenPlum,DeepGreen,HAWK 等,使用 FDW 进行 ETL。
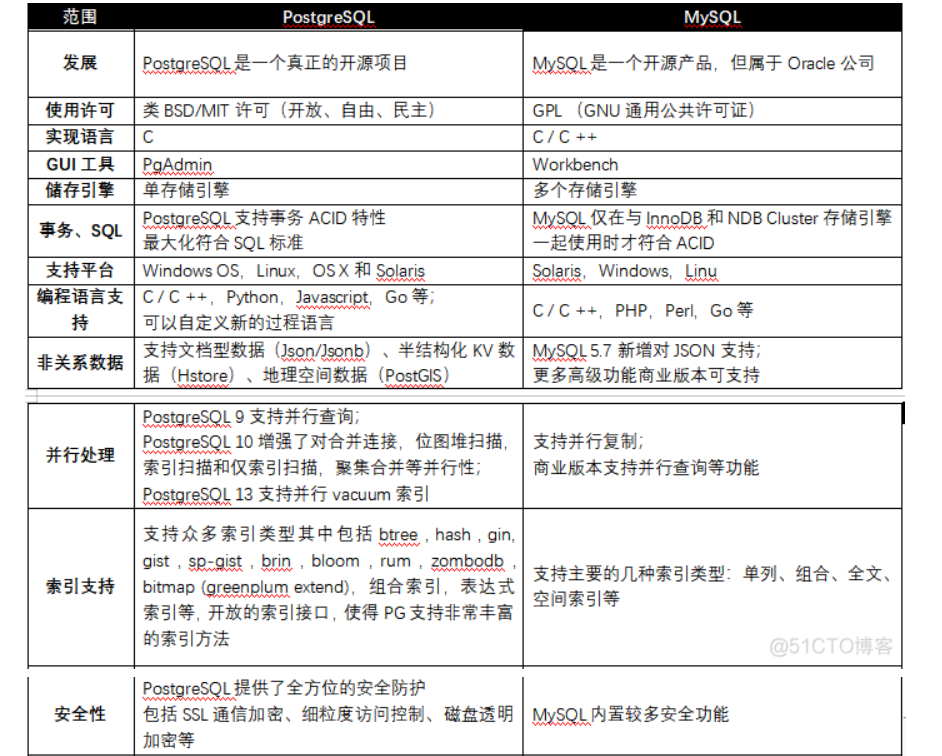
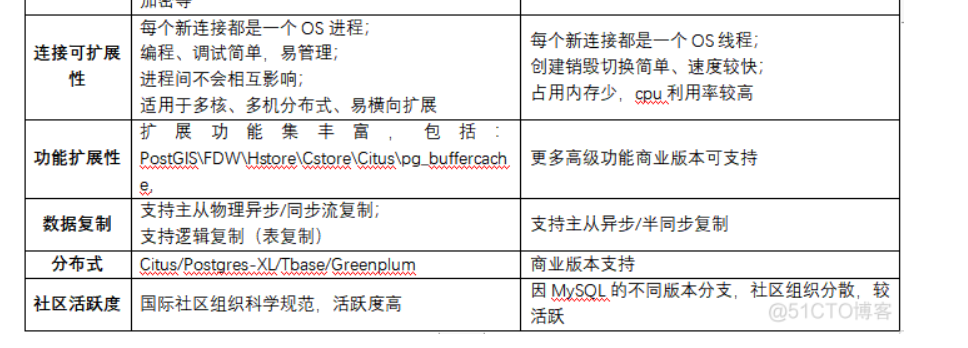
postgresql和mysql对比
Postgres是一个对象关系数据库(ORDBMS),具有表继承和函数重载等功能,可以处理复杂的查询和大型数据库。
而MySQL就是一个纯粹的关系数据库(RDBMS)相对易于建立和管理,快速,可靠且易于理解。
1、PostgreSQL优点:
Ø 丰富的功能和扩展
PostgreSQL 拥有强劲的功能集,其中包括多版本并发控制 (MVCC)、时点恢复、细粒度访问控制、表空间、异步复制、嵌套事务、联机/热备份、完善的查询规划器/优化器以及预写式日志。它支持国际字符集、多字节字符编码和 Unicode,并且在排序、区分大小写和格式设置等方面具备区域感知功能。PostgreSQL 在可管理的数据量和可容纳的并发用户量方面均能够高度扩展。
Ø 可靠性和标准合规性
PostgreSQL 的预写式日志功能使其成为具备高容错能力的数据库。其庞大的开源贡献者群为其提供了内置社区支持网络。PostgreSQL 可与 ACID 兼容,并且对外键、连接、视图、触发器和存储的程序提供多种语言的全套支持。它包括大多数 SQL:2008 数据类型,包括 INTEGER、NUMERIC、BOOLEAN、CHAR、VARCHAR、DATE、INTERVAL 和 TIMESTAMP。此外,它还支持存储二进制大对象,包括图片、语音或视频。
Ø 开源许可
PostgreSQL 源代码可通过开源许可证获取,这让您能够根据需要自由使用、修改和实施它,同时无任何费用。PostgreSQL 不会产生许可费用,这消除了过度部署的风险。PostgreSQL 专属的贡献者和爱好者社区会定期查找错误并修复,致力于确保数据库系统的整体安全性。
2、MySQL 优点:
Ø 易于使用,性能强大
MySQL 数据库易于使用,功能强大,支持触发器、存储的程序和可以更新的视图,受到了 Web 开发人员的青睐。MySQL 包含多种实用工具,例如备份程序 mysqldump、管理客户端 mysqladmin 和用于管理工作和迁移工作的 GUI MySQL Workbench。
随着时间的推移,MySQL 推出了包含索引压缩的 B-tree 磁盘表、基于线程的内存分配和优化的嵌套循环连接等功能,提升了其性能。存储引擎中的行级锁定和一致性读取为 MySQL 提供了支持多用户并发的额外性能优势。
Ø 可靠性与安全性
MySQL 的 InnoDB 事务性存储引擎符合 ACID 模型,具有改进数据保护的功能,例如时间点恢复和自动提交。InnoDB 支持外键约束,可以避免不同表中的数据不一致,从而实现更高的数据完整性。
MySQL 附带强化而灵活的安全功能,其中包括基于主机的验证和密码流量加密。InnoDB 采用双层加密密钥架构进行静态数据表空间加密,具备额外的安全优势。
Ø 开源许可
MySQL 采用开源许可(GNU 通用公共许可),您可以自由使用和修改源代码。
MySQL 在全球有大规模的贡献者和爱好者社区,为使用这种数据库系统带来了许多额外的长期优势。例如,MySQL 社区一直关注安全问题和错误修复,提高了软件的整体弹性。MySQL 的用户群、活动、论坛和邮寄名单组成了一个内建的教育和支持网络。
PostgreSQL 常见使用案例
Ø 通用型 OLTP 数据库
初创公司和大型企业等使用 PostgreSQL 作为主数据存储来支持其 Internet 规模的应用程序、解决方案和产品。
Ø 地理空间数据库
与 PostGIS 扩展结合使用时,PostgreSQL 支持地理对象,可用作基于位置的服务和地理信息系统 (GIS) 的地理空间数据存储。
Ø 联合中心数据库
PostgreSQL 的外部数据封装器和 JSON 支持允许它与其他数据存储(包括 NoSQL 类型)关联,并用作混合数据库系统的联合中心。
Ø LAPP 开源堆栈
PostgreSQL 可将动态网络和应用程序作为 LAMP 堆栈(LAPP 代表“Linux、Apache、PostgreSQL、PHP、Python 和 Perl”)的一个主要替代品的一部分运行。
Sqlite
SQLite是一款轻型的嵌入式数据库.它的数据库就是一个文件.
小型嵌入式,跟mysql差不多,但是更小,功能相对较少,它占用的资源非常低,可能只需要几百k的内存就够了.
是一个真正开源的无限制的数据库,跨平台,支持Linux, Mac , Android, iOS和 Windows 等,主要应用于嵌入式开发.
SQLite的优点
- 源代码不受版权限制,真正的自由,开源和免费.
- 无服务器,不需要一个单独的服务器进程或者操作的系统
- 一个SQLite 数据库是存储在一个单一的跨平台的磁盘文件
- 零配置,因为其本身就是一个文件,不需要安装或管理,轻松携带
- 不需要任何外部的依赖,所有的操作等功能全部都在自身集成.
- 轻量级,SQLite本身是C写的,体积很小,经常被集成到各种应用程序中.
SQLite的缺点
- 缺乏用户管理和安全功能
- 只能本地嵌入,无法被远程的客户端访问,需要上层应用来处理这些事情;
- 不适合大数据
- 适合单线程访问,对多线程高并发的场景不适用;
- 各种数据库高级特性它都不支持,比如管理工具、分析工具、维护等等;
SQLite的应用场景
小型网站
SQLite适用于中小规模流量的网站.
日访问在10万以下的网站可以很好的支持,适用于读多写少的操作,如管理员在后台添加数据,其他访客多为浏览.
10万/天是一个临界值,事实上在100万的数据量之下,SQLite的表现还是可以的,在往上就不适合了.
使用它无需单独购买数据库服务,无需服务器进程,配置成本几乎为零,加上数据的导入导出都是复制文件,维护难度也几乎为零,迁移到别的服务器无需任何配置即可支持,加上其读取的速度非常快,省去了远程数据库的链接,能够极大提升网站访问速度.
嵌入式设备
SQLite适用于手机, PDA, 机顶盒, 以及其他嵌入式设备. 作为一个嵌入式数据库它也能够很好的应用于客户端程序.
因为其轻量,小巧,不怎么占用内存,数据的读写性能好,加上嵌入式设备数据量并不大,不需要频繁的维护,所以比较适合.
数据库教学
SQLite 支持 SQL92(SQL2)标准的大多数查询语言的功能。
其无配置,无依赖,小巧,单一文件的特性让它的安装和使用非常简单,非常适合用来讲解SQL语句.
学生可以在很短的时候使用并操作SQLite,不受系统和商业限制等影响,学习的结果可以通过邮件或者云文件等形式发送给老师进行评分.
可以通过它快速实现一个最小化应用,适合学生快速了解SQLite,以及SQL语法,从而实现数据库的触类旁通,了解其他数据库系统的设计实现原则.
本地应用程序
其单一磁盘文件的特性,并且不支持远程连接,使其适用于本地的应用程序,如PC客户端软件.
常用的应用类型为金融分析工具、CAD 包、档案管理程序等等. (手机上的通讯录也是用此开发的)
没有远程,意味着适用于内部或者临时的数据库,用来处理一些数据,让程序更加灵活.
Sequelize
Sequelize.js是一款针对nodejs的ORM框架。
使用nodejs连接过数据库的人肯定对数据库不陌生了。如果是直接链接,需要自己建立并管理连接,还需要手动编写sql语句。简单的项目到是无所谓,可是一旦项目设计的东西比较复杂,表比较多的时候整个sql的编写就非常的消耗精力。
Sequelize是针对node.js和io.js提供的ORM框架。具体就是突出一个支持广泛,配置和查询方法统一。它支持的数据库包括:PostgreSQL、 MySQL、MariaDB、 SQLite 和 MSSQL。
Sequelize的调用突出一个简单快捷。
Table1.findById(23);
//select a,b,c,d from table1 where id=23;

Table1.findAll({
    where:{a:"test",b:76}
});
//select a,b,c,d from table1 where a="test" and "b=76;
连接数据库
Sequelize的连接需要传入参数,并且可以配置开启线程池、读写分库等操作。
简单的写法是这样的:new Sequelize("表名","用户名","密码",配置)
正常使用中很少使用到所有的参数,这里提供一个常用的模板,只需要修改自己使用的值即可。
const sequelize = new Sequelize('database', 'username', 'password',  {
  host: 'localhost',    //数据库地址,默认本机
  port:'3306',
  dialect: 'mysql',
  pool: {   //连接池设置
    max: 5, //最大连接数
    min: 0, //最小连接数
    idle: 10000
  },
 });
下面是详细的配置参数。
const sequelize = new Sequelize('database', 'username', 'password', {
  // 数据库类型,支持: 'mysql', 'sqlite', 'postgres', 'mssql'
  dialect: 'mysql',
  // 自定义链接地址,可以是ip或者域名,默认本机:localhost
  host: 'my.server.tld',
  // 自定义端口,默认3306
  port: 12345,
  // postgres使用的参数,连接类型,默认:tcp
  protocol: null,
  // 是否开始日志,默认是用console.log
  // 建议开启,方便对照生成的sql语句
  logging: true,
  // 默认是空
  // 支持: 'mysql', 'postgres', 'mssql'
  dialectOptions: {
    socketPath: '/Applications/MAMP/tmp/mysql/mysql.sock',
    supportBigNumbers: true,
    bigNumberStrings: true
  },
  // sqlite的存储位置,仅sqlite有用
  // - 默认 ':memory:'
  storage: 'path/to/database.sqlite',

  // 是否将undefined转化为NULL
  // - 默认: false
  omitNull: true,
  // pg中开启ssl支持
  // - 默认: false
  native: true,
  // 数据库默认参数,全局参数
  define: {
    underscored: false
    freezeTableName: false,
    charset: 'utf8',
    dialectOptions: {
      collate: 'utf8_general_ci'
    },
    timestamps: true
  },
  // 是否同步
  sync: { force: true },
  // 连接池配置
  pool: {
    max: 5,
    idle: 30000,
    acquire: 60000,
  },
  isolationLevel: Transaction.ISOLATION_LEVELS.REPEATABLE_READ
})
定义模型对象
在使用之前一定要先创建模型对象。就是数据库中表的名称、使用到的字段、字段类型等。
这里有一个推荐的开发方式。先在nodejs中将对象创建出来,然后调用Sequelize的同步方法,将数据库自动创建出来。这样就避免了既要写代码建表,又要手工创建数据库中的表的操作。只需要单独考虑代码中的对象类型等属性就好了。
如果数据库中已经建好了表,并且不能删除,这个时候就不能自动创建了,因为创建的时候会删除掉旧的数据。
下面是简单的对象创建多数情况下这样就可以了。
const users = db.define('t_user'/*自定义表名*/, {
    id: {
        type: Sequelize.INTEGER,
        primaryKey: true,       //主键
        autoIncrement: true,    //自增
        comment: "自增id"       //注释:只在代码中有效
    },
    //用户名
    username: {
        type: Sequelize.STRING,
        validate:{
            isEmail: true,   //类型检测,是否是邮箱格式
        }
    },
    //密码
    pwd: {
        type: Sequelize.STRING(10),
        allowNull: false,//不允许为null
    },
    //状态
    status: {
        type: Sequelize.INTEGER,
         defaultValue: 0,//默认值是0
    },
    //昵称
    nickname: {
        type: Sequelize.STRING
    },
    //token
    token: {
        type: Sequelize.UUID
    },
    create_time: {
        type: Sequelize.DATE,
        defaultValue: Sequelize.NOW
    }
}, {
    //使用自定义表名
    freezeTableName: true,
    //去掉默认的添加时间和更新时间
    timestamps: false,
    indexes:[
        //普通索引,默认BTREE
        {
            unique: true,
            fields: ['pid']
        },
     ]
});

//同步:没有就新建,有就不变
// users.sync();
//先删除后同步
users.sync({
    force: true
});
数据类型
前段将了对象的创建,里面用到了对象的各种类型。这里再介绍一下类型的具体使用方式。
Sequelize.STRING        //字符串,长度默认255,VARCHAR(255)
Sequelize.STRING(1234)  //设定长度的字符串,VARCHAR(1234)
Sequelize.STRING.BINARY   //定义类型VARCHAR BINARY
Sequelize.TEXT           //长字符串,文本 TEXT
Sequelize.TEXT('tiny')   //小文本字符串,TINYTEXT

Sequelize.INTEGER      //int数字,int
Sequelize.BIGINT       //更大的数字,BIGINT
Sequelize.BIGINT(11)   //设定长度的数字,BIGINT(11)

Sequelize.FLOAT        //浮点类型,FLOAT
Sequelize.FLOAT(11)     //设定长度的浮点,FLOAT(11)
Sequelize.FLOAT(11, 12)  //设定长度和小数位数的浮点,FLOAT(11,12)

Sequelize.REAL     //REAL  PostgreSQL only.
Sequelize.REAL(11) // REAL(11)    PostgreSQL only.
Sequelize.REAL(11, 12)  // REAL(11,12) PostgreSQL only.

Sequelize.DOUBLE     // DOUBLE
Sequelize.DOUBLE(11)  // DOUBLE(11)
Sequelize.DOUBLE(11, 12) // DOUBLE(11,12)

Sequelize.DECIMAL     // DECIMAL
Sequelize.DECIMAL(10, 2)  // DECIMAL(10,2)

Sequelize.DATE    // 日期类型,DATETIME for mysql / sqlite, TIMESTAMP WITH TIME ZONE for postgres
Sequelize.DATE(6) // mysql 5.6.4+支持,分秒精度为6位
Sequelize.DATEONLY   // 仅日期部分
Sequelize.BOOLEAN   // int类型,长度为1,TINYINT(1)

Sequelize.ENUM('value 1', 'value 2')  // 枚举类型
Sequelize.ARRAY(Sequelize.TEXT)  //PostgreSQL only.
Sequelize.ARRAY(Sequelize.ENUM)  //  PostgreSQL only.

Sequelize.JSON   // JSON column. PostgreSQL, SQLite and MySQL only.
Sequelize.JSONB  // JSONB column. PostgreSQL only.

Sequelize.BLOB   // BLOB (bytea for PostgreSQL)
Sequelize.BLOB('tiny')  // TINYBLOB (bytea for PostgreSQL. Other options are medium and long)

Sequelize.UUID  // PostgreSQL和SQLite的数据类型是UUID, MySQL是CHAR(36)类型

Sequelize.CIDR  // PostgreSQL中的CIDR类型
Sequelize.INET   // PostgreSQL中的INET类型
Sequelize.MACADDR  // PostgreSQL中的MACADDR类型

Sequelize.RANGE(Sequelize.INTEGER)    //PostgreSQL only.
Sequelize.RANGE(Sequelize.BIGINT)     // PostgreSQL only.
Sequelize.RANGE(Sequelize.DATE)       //PostgreSQL only.
Sequelize.RANGE(Sequelize.DATEONLY)   //PostgreSQL only.
Sequelize.RANGE(Sequelize.DECIMAL)    //PostgreSQL only.

Sequelize.ARRAY(Sequelize.RANGE(Sequelize.DATE)) // PostgreSQL only.

Sequelize.GEOMETRY   //PostgreSQL (with PostGIS) or MySQL only.
Sequelize.GEOMETRY('POINT')  // PostgreSQL (with PostGIS) or MySQL only.
Sequelize.GEOMETRY('POINT', 4326)// PostgreSQL (with PostGIS) or MySQL only.
数据类型检测
上面可以看到使用validate字段去验证字段的值是否符合标准,这样就可以在入库之前就能知道数据是否符合规则。否则贸然将陌生的数据存入数据库就好像将陌生人带到家里一样,是否安全全靠缘分啊。
Sequelize内置支持的验证还是非常的多的,如果这些都不满意,还可以自己定义一个。
validate: {
    is: ["^[a-z]+$",'i'],     // 全匹配字母
    is: /^[a-z]+$/i,          // 全匹配字母,用规则表达式写法
    not: ["[a-z]",'i'],       // 不能包含字母
    isEmail: true,            // 检查邮件格式
    isUrl: true,              // 是否是合法网址
    isIP: true,               // 是否是合法IP地址
    isIPv4: true,             // 是否是合法IPv4地址
    isIPv6: true,             // 是否是合法IPv6地址
    isAlpha: true,            // 是否是字母
    isAlphanumeric: true,     // 是否是数字和字母
    isNumeric: true,          // 只允许数字
    isInt: true,              // 只允许整数
    isFloat: true,            // 是否是浮点数
    isDecimal: true,          // 是否是十进制书
    isLowercase: true,        // 是否是小写
    isUppercase: true,        // 是否大写
    notNull: true,            // 不允许为null
    isNull: true,             // 是否是null
    notEmpty: true,           // 不允许为空
    equals: 'specific value', // 等于某些值
    contains: 'foo',          // 包含某些字符
    notIn: [['foo', 'bar']],  // 不在列表中
    isIn: [['foo', 'bar']],   // 在列表中
    notContains: 'bar',       // 不包含
    len: [2,10],              // 长度范围
    isUUID: 4,                // 是否是合法 uuids
    isDate: true,             // 是否是有效日期
    isAfter: "2011-11-05",    // 是否晚于某个日期
    isBefore: "2011-11-05",   // 是否早于某个日期
    max: 23,                  // 最大值
    min: 23,                  // 最小值
    isArray: true,            // 是否是数组
    isCreditCard: true,       // 是否是有效信用卡号
    // 自定义规则
    isEven: function(value) {
    if(parseInt(value) % 2 != 0) {
        throw new Error('请输入偶数!')
    }
}
常用API
查询多条 findAll(opts) 或者 all(opts)
查询用的参数普遍通用,只有部分API的有特殊参数。这里展示一次常用参数,下面就略过了。
let list = await model.findAll({
    where:{
        id:{$gt:10},//id大于10的
        name:"test"  //name等于test
    },
    order:[
        "id",   //根据id排序
        ["id","desc"]//根据id倒序
    ],
    limit:10,//返回个数
    offset:20,//起始位置,跳过数量
    attributes:["attr1","attr2"], //返回的字段
});
//select attr1,attr2 from model where ......
通过id查询 findById(id,opts)
这里默认数据的主键是id,查询的时候直接通过id查询数据。这里推荐在新建数据库的时候可以添加id作为唯一主键。
let model = await model.findById(12);
//select a,b,c from model where id=12;
查询一条记录 findOne(opts)
根据条件查询记录,这里的条件一定要填写,不然就是返回第一条数据了。
let model = await model.findOne({
    where:{id:12}
});
//select a,b,c from model where id=12;
分页查询 findAndCount(opts) 或者 findAndCountAll
分页查询恐怕是另外一个常用方法了。任何一个列表都有需要分页的时候。
这个方法会同时执行2跳语句。
let data = await model.findAndCount({
    limit:10,//每页10条
    offset:0*10,//第x页*每页个数
    where:{}
});
let list = data.rows;
let count = data.count;
//select count(*) from model where ...;
//select a,b,c from model where .... limit 0,10;
添加新数据 create(model,opts)
添加就非常的自在了。简单的只需要传入model对象即可。这里要保证model对象的属性和字段名要一致。如果不一致就会出错。也可以传入配置参数来增加条件等。
let model= {
    name:"test",
    token:"adwadfv2324"
}
 await model.create(model);
//insert into model (name,token) values("test","adwadfv2324");
查询,不存在就返回默认对象 findOrInitialize(opts)
opts.default 默认值对象
这个方法首先会查询数据库,如果没有结果就会返回参数中的default对象。这个比较适合返回默认对象之类的场景。
查询,不存在就新建一个 findOrCreate(opts)或者findCreateFind
这个方法用到的情况也比较多。通常用于自动创建不存在的数据。直接就返回了默认值。
有则更新,无则添加 upsert(model,opts) 或者 insertOrUpdate(model,opts)
根据主键或者唯一约束键匹配
常用于编辑的时候添加或者更新统一操作。
更新记录 update(model,opts)
就是最常用的更新方法,可以传入要更新的model对象,同时用配置参数有条件的区别要更新的对象。
删除记录 destroy(opts)
删除有2种情况,一种是物理删除。删除就从表中不存在了。另外一种就是设置paranoid,这个是虚拟删除,默认一个字段表示数据是否删除,查询的时候去掉这个条件即可查询到删除的数据。
恢复记录 restore(opts)
恢复多个实例,当启用paranoid时就可以使用这个方法将曾今删除的数据恢复了。
其他常用API
- 指定字段查询最大值 max("id",opts)
- 指定字段查询最小值 min("id",opts)
- 求和 sum("id",opts)
- 批量添加 bulkCreate([model],opts)
- 查表结构的信息 describe()
- 递增 increment("id",{by:1})
- 递减 decrement("id",{by:1})
- 统计查询个数 count(opts)
事务
Sequelize中的事务比较简单。但是如果有多个事务的话写出来的代码会非常的难看。这也算是Sequelize优化的比较差的地方了。
需要记得transaction参数要一致传递就可以了。其他就是一个正常的Promise调用。
//调用Sequelize初始化之后的sequelize对象
return sequelize.transaction(function (t) {
    //返回最终的Promise
  return User.create({
    firstName: 'Abraham',
    lastName: 'Lincoln'
  }, {transaction: t}).then(function (user) {
    return user.setShooter({
      firstName: 'John',
      lastName: 'Boothe'
    }, {transaction: t});
  });
}).then(function (result) {
  //主动调用commit提交结果
  return t.commit();
}).catch(function (err) {
  //主动回滚操作
  return t.rollback();
});
多表联查
外键可能算是Sequelize中的一个难点了。这里涉及的东西稍微多一点,我们来慢慢捋一遍。
外键知识点
外键的定制作用----三种约束模式:
- district:严格模式(默认), 父表不能删除或更新一个被子表引用的记录。
- cascade:级联模式, 父表操作后,子表关联的数据也跟着一起操作。也是Sequelize的默认模式。
- set null:置空模式,前提外键字段允许为NLL, 父表操作后,子表对应的字段被置空。
使用外键的前提
在Sequelize中使用外键需要提前检查一下下面的这些选项,里面有一条出错就会导致设置失败。
- 表储存引擎必须是innodb,否则创建的外键无约束效果。
- 外键的列类型必须与父表的主键类型完全一致。
- 外键的名字不能重复。
- 已经存在数据的字段被设为外键时,必须保证字段中的数据与父表的主键数据对应起来。
使用示例---默认
默认情况下,主键使用的是主表的id字段,外键是使用的按照table+字段的方式建立的外键。一般情况下需要手动指定。
//主表指定关系
 test1.hasMany(test2, {
     foreignKey: "pid",//外键名称
 });
 //子表指定关系
 test2.belongsTo(test1, {
     foreignKey: "pid",//外键名称
 });
默认就会在子表中添加一条外键记录,指向的就是主表的id。一般情况下这样就能够满足正常的使用了。比如一个主表记录商品信息,一个子表记录多个评论消息。
使用示例---自定义
如果主表使用的主键id并不能满足正常的使用,还可以指定某一个固定的字段作为主表中的约束关系。
tips:主表中如果不是使用id作为主要关系,自定义的字段必须添加索引等条件,作为依赖中的关系。
 test1.hasMany(test2, {
     foreignKey: "pid",//外键字段名
     sourceKey: "pid",//主键字段名
 });
 test2.belongsTo(test1, {
     foreignKey: "pid",//关联名
     targetKey:"pid"//自定义外键字段
 });
 //等待主键建立成功再建立子表的外键关系
 setTimeout(() => {
    test2.sync({
        force: true
    });
}, 2500);
使用示例---伪关系
实际使用的时候我还是倾向于这种关系。即表中关系已定的情况下仅仅指定外键关系。同步的时候仅仅同步表内容,不同步这个外键关系。
真正的建立可以使用手动建表的时候添加。或者也可以在自动建表结束后异步再执行一次外键关系的添加。
 test1.hasMany(test2, {
     foreignKey: "pid",
     sourceKey: "pid",
     constraints: false //不同步建立外键关系
 });
 test2.belongsTo(test1, {
     foreignKey: "pid",
     targetKey:"pid",
     constraints: false //不同步建立外键关系
 });
示例
实际的操作部分大家可以看github中的test.js。github地址
单表操作
Sequelize在查询结果返回之后会返回一个它自定义的对象。这个对象是支持继续操作的,其中具体的值存放在datavalues中。不过可以放心的是在转化为字符串的时候是不会带有任何Sequelize的属性的。
//根据条件查询一条数据
let model = await test1.findOne({
    where:{
        id:5,
        name:"test"
    }
});
//修改其中的name字段的值
model.name="更新";
//保存,会自动update数据库中的值
model.save();
联查
正常的使用过程中很少会说只需要查询一个表就能结果问题的。这里再说一下2个表查询的时候是怎么使用的。
这里的查询默认已经做好了外键的的关系。不过在使用的时候不做也是可以的,就是在查询的时候性能稍微不好而已。
//查询主表list的数据
//一条list中的数据对应多条item中的数据
 let data = await models.List.findAll({
     where:{id:5},//条件,这里jiashe只需查询一条
     include: [{
         model: models.Item,
         as:"items",//返回的对象修改成一个固定的名称
     }]
 });
 let list1=data[0];//返回的第一条数据就是要查询的数据
 let list2=list1.items;//返回子表数据,items是自定义的名称
语句练习
基本表结构:
student(sno,sname,sage,ssex)学生表
course(cno,cname,tno) 课程表
sc(sno,cno,score) 成绩表

teacher(tno,tname) 教师表
题目
101,查询课程1的成绩比课程2的成绩高的所有学生的学号
select a.sno from
(select sno,score from sc where cno=1) a,
(select sno,score from sc where cno=2) b
where a.score>b.score and a.sno=b.sno


102,查询平均成绩大于60分的同学的学号和平均成绩
select a.sno as "学号", avg(a.score) as "平均成绩"
from
(select sno,score from sc) a
group by sno having avg(a.score)>60


103,查询所有同学的学号、姓名、选课数、总成绩
select a.sno as 学号, b.sname as 姓名,
count(a.cno) as 选课数, sum(a.score) as 总成绩
from sc a, student b
where a.sno = b.sno
group by a.sno, b.sname

或者:

selectstudent.sno as 学号, student.sname as 姓名,
 count(sc.cno) as 选课数, sum(score) as 总成绩
from student left Outer join sc on student.sno = sc.sno
group by student.sno, sname

104,查询姓“张”的老师的个数

selectcount(distinct(tname)) from teacher where tname like '张%‘

或者:

select tname as "姓名", count(distinct(tname)) as "人数"  from teacher
where tname like'张%'
group by tname


105,查询没学过“张三”老师课的同学的学号、姓名
select student.sno,student.sname from student
where sno not in (select distinct(sc.sno) from sc,course,teacher
where sc.cno=course.cno and teacher.tno=course.tno and teacher.tname='张三')


106,查询同时学过课程1和课程2的同学的学号、姓名
select sno, sname from student
where sno in (select sno from sc where sc.cno = 1)
and sno in (select sno from sc where sc.cno = 2)
或者:

selectc.sno, c.sname from
(select sno from sc where sc.cno = 1) a,
(select sno from sc where sc.cno = 2) b,
student c
where a.sno = b.sno and a.sno = c.sno
或者:

select student.sno,student.sname from student,sc where student.sno=sc.sno and sc.cno=1
and exists( select * from sc as sc_2 where sc_2.sno=sc.sno and sc_2.cno=2)


107,查询学过“李四”老师所教所有课程的所有同学的学号、姓名
select a.sno, a.sname from student a, sc b
where a.sno = b.sno and b.cno in
(select c.cno from course c, teacher d where c.tno = d.tno and d.tname = '李四')

或者:

select a.sno, a.sname from student a, sc b,
(select c.cno from course c, teacher d where c.tno = d.tno and d.tname = '李四') e
where a.sno = b.sno and b.cno = e.cno


108,查询课程编号1的成绩比课程编号2的成绩高的所有同学的学号、姓名
select a.sno, a.sname from student a,
(select sno, score from sc where cno = 1) b,
(select sno, score from sc where cno = 2) c
where b.score > c.score and b.sno = c.sno and a.sno = b.sno


109,查询所有课程成绩小于60分的同学的学号、姓名
select sno,sname from student
where sno not in (select distinct sno from sc where score > 60)


110,查询至少有一门课程与学号为1的同学所学课程相同的同学的学号和姓名
select distinct a.sno, a.sname
from student a, sc b
where a.sno <> 1 and a.sno=b.sno and
b.cno in (select cno from sc where sno = 1)

或者:

select s.sno,s.sname
from student s,
(select sc.sno
from sc
where sc.cno in (select sc1.cno from sc sc1 where sc1.sno=1)and sc.sno<>1
group by sc.sno)r1
where r1.sno=s.sno

111、把“sc”表中“王五”所教课的成绩都更改为此课程的平均成绩
update sc set score = (select avg(sc_2.score) from sc sc_2 wheresc_2.cno=sc.cno)
from course,teacher where course.cno=sc.cno and course.tno=teacher.tno andteacher.tname='王五'


112、查询和编号为2的同学学习的课程完全相同的其他同学学号和姓名
这一题分两步查:

1,

select sno
from sc
where sno <> 2
group by sno
having sum(cno) = (select sum(cno) from sc where sno = 2)

2,
select b.sno, b.sname
from sc a, student b
where b.sno <> 2 and a.sno = b.sno
group by b.sno, b.sname
having sum(cno) = (select sum(cno) from sc where sno = 2)

113、删除学习“王五”老师课的sc表记录
delete sc from course, teacher
where course.cno = sc.cno and course.tno = teacher.tno and tname = '王五'

114、向sc表中插入一些记录,这些记录要求符合以下条件:
将没有课程3成绩同学的该成绩补齐, 其成绩取所有学生的课程2的平均成绩
insert sc select sno, 3, (select avg(score) from sc where cno = 2)
from student
where sno not in (select sno from sc where cno = 3)

115、按平平均分从高到低显示所有学生的如下统计报表:
-- 学号,企业管理,马克思,UML,数据库,物理,课程数,平均分
select sno as 学号
,max(case when cno = 1 then score end) AS 企业管理
,max(case when cno = 2 then score end) AS 马克思
,max(case when cno = 3 then score end) AS UML
,max(case when cno = 4 then score end) AS 数据库
,max(case when cno = 5 then score end) AS 物理
,count(cno) AS 课程数
,avg(score) AS 平均分
FROM sc
GROUP by sno
ORDER by avg(score) DESC

116、查询各科成绩最高分和最低分:

以如下形式显示:课程号,最高分,最低分
select cno as 课程号, max(score) as 最高分, min(score) 最低分
from sc group by cno

select  course.cno as '课程号'
,MAX(score) as '最高分'
,MIN(score) as '最低分'
from sc,course
where sc.cno=course.cno
group by course.cno

117、按各科平均成绩从低到高和及格率的百分数从高到低顺序
SELECT t.cno AS 课程号,
max(course.cname)AS 课程名,
isnull(AVG(score),0) AS 平均成绩,
100 * SUM(CASE WHEN isnull(score,0)>=60 THEN 1 ELSE 0 END)/count(1) AS 及格率
FROM sc t, course
where t.cno = course.cno
GROUP BY t.cno
ORDER BY 及格率 desc

118、查询如下课程平均成绩和及格率的百分数(用"1行"显示):

企业管理(001),马克思(002),UML (003),数据库(004)
select
avg(case when cno = 1 then score end) as 平均分1,
avg(case when cno = 2 then score end) as 平均分2,
avg(case when cno = 3 then score end) as 平均分3,
avg(case when cno = 4 then score end) as 平均分4,
100 * sum(case when cno = 1 and score > 60 then 1 else 0 end) / sum(casewhen cno = 1 then 1 else 0 end) as 及格率1,
100 * sum(case when cno = 2 and score > 60 then 1 else 0 end) / sum(casewhen cno = 2 then 1 else 0 end) as 及格率2,
100 * sum(case when cno = 3 and score > 60 then 1 else 0 end) / sum(casewhen cno = 3 then 1 else 0 end) as 及格率3,
100 * sum(case when cno = 4 and score > 60 then 1 else 0 end) / sum(casewhen cno = 4 then 1 else 0 end) as 及格率4
from sc

119、查询不同老师所教不同课程平均分, 从高到低显示
select max(c.tname) as 教师, max(b.cname) 课程, avg(a.score) 平均分
from sc a, course b, teacher c
where a.cno = b.cno and b.tno = c.tno
group by a.cno
order by 平均分 desc
或者:
select r.tname as '教师',r.rname as '课程' , AVG(score) as '平均分'
from sc,
(select  t.tname,c.cno as rcso,c.cname as rname
from teacher t ,course c
where t.tno=c.tno)r
where sc.cno=r.rcso
group by sc.cno,r.tname,r.rname
order by AVG(score) desc

120、查询如下课程成绩均在第3名到第6名之间的学生的成绩:
-- [学生ID],[学生姓名],企业管理,马克思,UML,数据库,平均成绩
select top 6 max(a.sno) 学号, max(b.sname) 姓名,
max(case when cno = 1 then score end) as 企业管理,
max(case when cno = 2 then score end) as 马克思,
max(case when cno = 3 then score end) as UML,
max(case when cno = 4 then score end) as 数据库,
avg(score) as 平均分
from sc a, student b
where a.sno not in

(select top 2 sno from sc where cno = 1 order by score desc)
  and a.sno not in (select top 2 sno from sc where cno = 2 order by scoredesc)
  and a.sno not in (select top 2 sno from sc where cno = 3 order by scoredesc)
  and a.sno not in (select top 2 sno from sc where cno = 4 order by scoredesc)
  and a.sno = b.sno
group by a.sno